Article · Recherche en éducation
L’acceptation n’est pas l’usage : ce que mesurent les enquêtes sur l’IA à l’école
© Pablo Correa Prieto, 2026 — CC BY 4.0
Quand une institution veut savoir si les enseignants utilisent l’IA générative, elle envoie un questionnaire. Et ce questionnaire est presque toujours construit sur le même modèle, celui de l’acceptation technologique. Le problème n’est pas le modèle. C’est l’écart entre ce qu’il mesure et ce qu’on lui demande de dire.
1.Ce que le modèle mesure vraiment
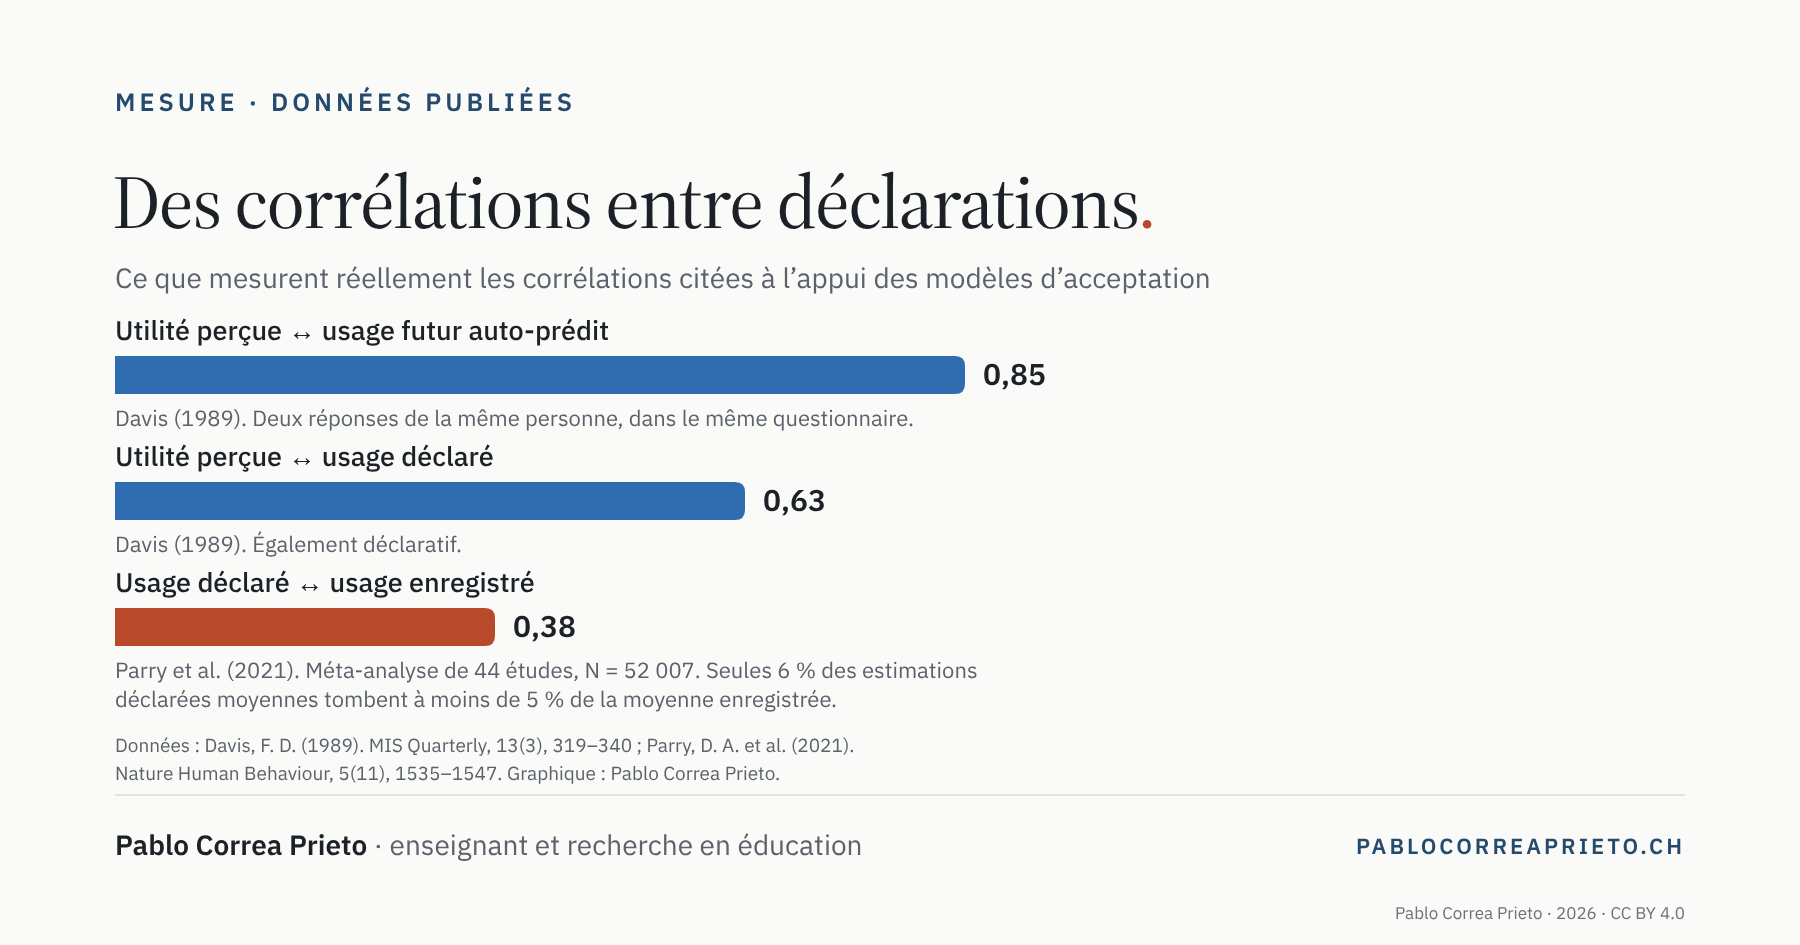
L’article fondateur de ce courant établit deux variables, l’utilité perçue et la facilité d’utilisation perçue, et les met en relation avec l’usage du système (Davis, 1989). Deux corrélations y sont rapportées : 0,63 entre l’utilité perçue et l’usage déclaré par les participants, et 0,85 entre l’utilité perçue et l’usage futur que les participants se prédisaient à eux-mêmes.
C’est le second chiffre qui est passé à la postérité, cité comme la preuve que le modèle prédit l’usage. Il faut le lire pour ce qu’il est : une corrélation entre deux réponses données par la même personne dans le même questionnaire. Ce n’est pas une mesure de comportement, c’est la cohérence interne d’une déclaration.
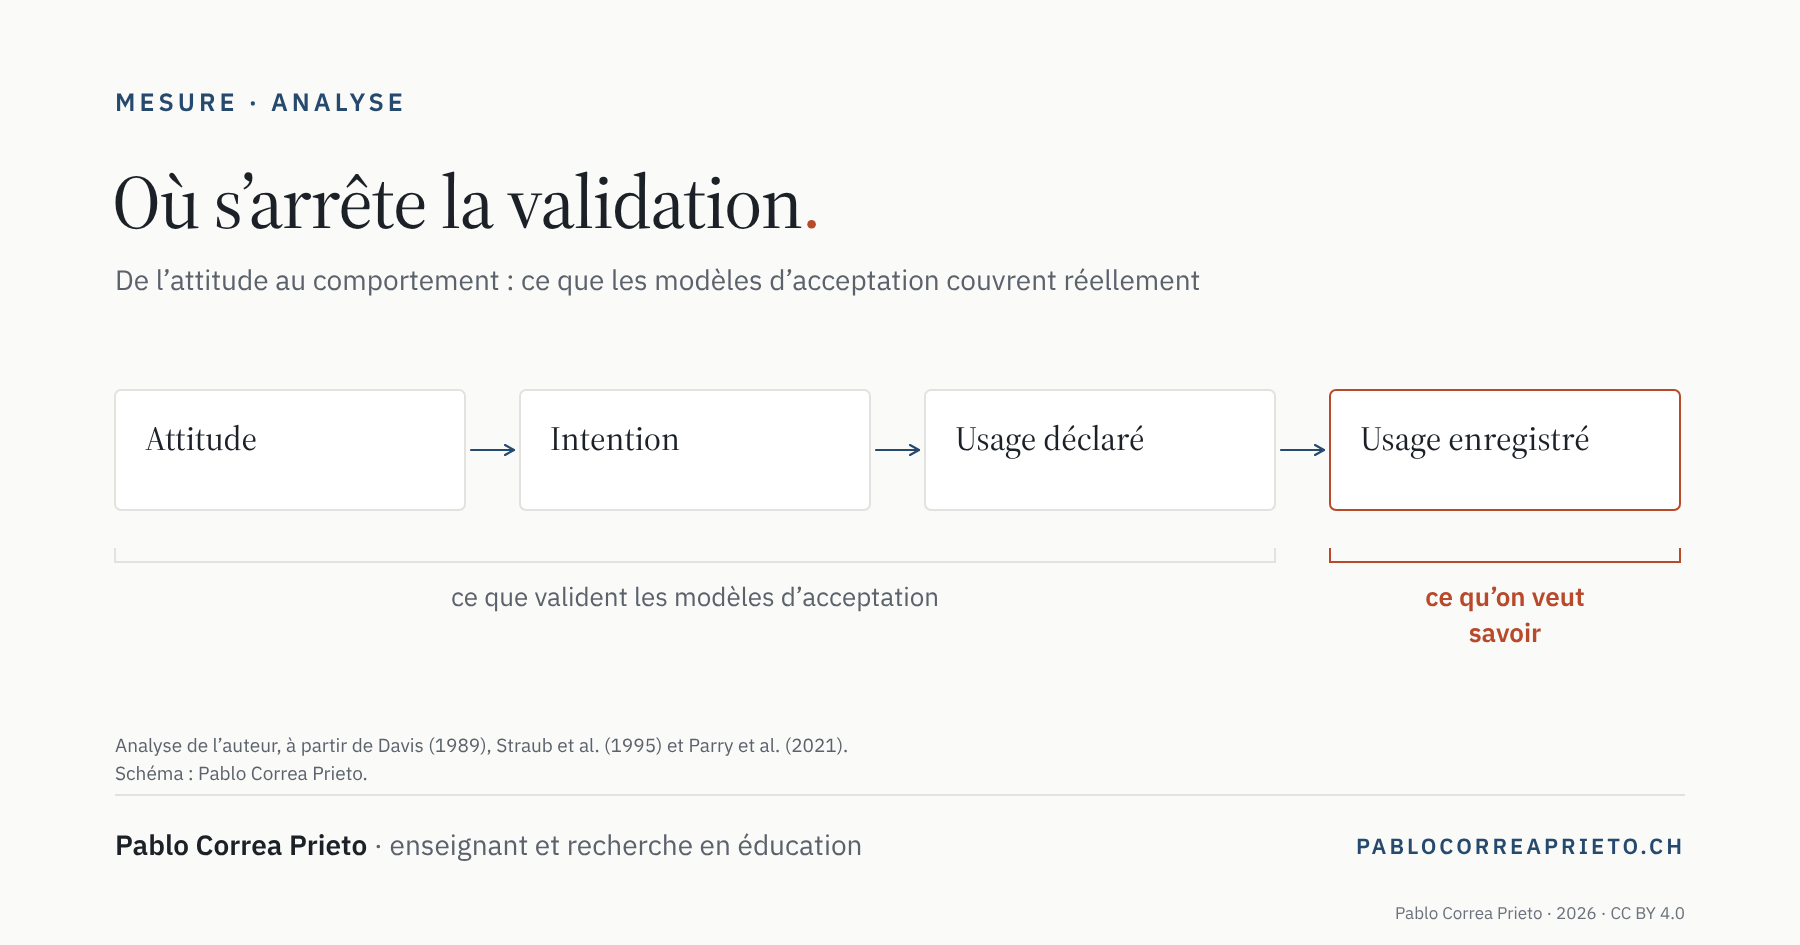
Le modèle unifié qui a suivi rapporte une variance expliquée de 69 % à 70 % (Venkatesh et al., 2003). Cette variance porte sur l’intention d’utiliser, et non sur l’usage. La distinction disparaît presque systématiquement dans les reprises.
© Pablo Correa Prieto, 2026 — CC BY 4.0
2.L’écart entre ce qu’on déclare et ce qu’on fait
La question a été posée tôt, et dans la même littérature. Une étude parue dans Management Science soutient que l’usage déclaré et l’usage enregistré par la machine sont deux construits distincts et que, contre toute attente, ils ne semblent pas fortement reliés l’un à l’autre (Straub et al., 1995). Les mesures objectives montrent des liens nettement plus faibles avec les variables du modèle que les mesures déclarées. Les auteurs en tirent eux-mêmes la conséquence : la recherche qui confirme le modèle à partir de mesures subjectives pourrait être, selon leur mot, artefactuelle.
Trente ans plus tard, une méta-analyse publiée dans Nature Human Behaviour a rassemblé les études qui comparent l’usage déclaré d’un média numérique à son usage enregistré (Parry et al., 2021). Sur 44 études et plus de 52 000 participants, la corrélation agrégée est de 0,38. La déclaration rend donc compte d’environ 14 % de la variance de l’usage réel. Plus parlant encore : seules 6 % des estimations déclarées moyennes tombaient à moins de 5 % de la moyenne enregistrée.
© Pablo Correa Prieto, 2026 — CC BY 4.0
Un détail de cette méta-analyse mérite l’attention. Le biais n’est pas systématique, car les participants ne surestiment pas régulièrement leur usage et l’intervalle de confiance du rapport entre déclaré et enregistré contient la valeur 1. Un biais constant pourrait être corrigé. Un biais bruité ne peut pas l’être.
Une étude plus récente retrouve ce profil, avec un résultat supplémentaire (Coyne et al., 2023). Plus l’instrument ressemble à une échelle d’attitude, moins il suit le comportement enregistré : les échelles d’usage problématique, de nomophobie ou de peur de manquer corrélaient entre 0,02 et 0,10 avec les données objectives, là où une simple estimation de durée atteignait 0,51. L’échantillon était composé de jeunes adultes et non d’enseignants, ce qui limite la portée du chiffre, mais le mécanisme est celui qui nous concerne.
3.Les enquêtes sur les enseignants font exactement cela
Une étude de 2026 auprès de 218 enseignants en poste du primaire et du secondaire applique un modèle d’acceptation étendu à l’IA générative (Tang et Zhong, 2026). La variable expliquée est l’intention d’utiliser ou de continuer à utiliser l’outil. Aucune donnée d’usage effectif n’est recueillie, alors que l’échantillon est composé d’enseignants dont une partie utilise déjà ces outils.
Une étude germanophone va un peu plus loin et mesure à la fois l’intention et l’usage (Dietrich et Grassini, 2025). Mais l’usage y est une fréquence auto-déclarée sur une échelle en sept points, recueillie dans le même instrument que l’intention. Son résultat le plus intéressant concerne les 56 enseignants de l’échantillon : chez eux, les prédicteurs classiques du modèle disparaissent, et c’est l’habitude qui prédit l’usage aussi fortement que l’intention. L’échantillon est petit pour la méthode employée, et je ne le prendrais pas pour une démonstration. Mais la direction est instructive : dès que la variable expliquée se rapproche un peu du comportement, les variables d’acceptation perdent leur prise.
4.Ce que cela change pour une enquête cantonale
Une enquête d’acceptation renseigne sur des attitudes. C’est une information réelle et utile, pour décider d’une offre de formation ou d’une communication. Elle ne dit pas ce qui se passe dans les classes, et la traiter comme un chiffre d’usage est une erreur de lecture, pas une approximation.
Si la question porte sur la pratique, il faut des traces de pratique : des préparations et des documents réellement produits, des entretiens portant sur les leçons de la semaine écoulée plutôt que sur des intentions, de l’observation. Chacune de ces voies coûte plus cher qu’un questionnaire, et certaines sont fermées. Les recommandations romandes interdisent de verser des productions d’élèves dans un outil d’IA générative tant que le canton n’en fournit pas un dont la fiabilité est garantie (CIIP, 2025).
Ce n’est pas un argument contre les modèles d’acceptation. Ils prédisent correctement ce qu’ils prédisent, et l’intention compte. C’est un argument contre une substitution : lire un score d’acceptation comme un taux d’usage.
Échangeons
Si vous menez ou lisez ce type d’enquête en Suisse romande, je serai heureux d’en discuter. Mes coordonnées : pablocorreaprieto.ch
Texte rédigé avec l’aide d’une IA, relu et validé par l’auteur.
Références
- CIIP. (2025). Intelligence artificielle générative – IAG : recommandations pour une utilisation réfléchie et mesurée dans l’enseignement. Conférence intercantonale de l’instruction publique de la Suisse romande et du Tessin. https://www.ciip.ch/files/1050/Documents/IRDP/Recommandations_IAG_19-03-2025_V10.pdf
- Coyne, P., Voth, J. et Woodruff, S. J. (2023). A comparison of self-report and objective measurements of smartphone and social media usage. Telematics and Informatics Reports, 10, Article 100061. https://doi.org/10.1016/j.teler.2023.100061
- Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319–340. https://doi.org/10.2307/249008
- Dietrich, L. K. et Grassini, S. (2025). Assessing ChatGPT acceptance and use in education: A comparative study among german-speaking students and teachers. Education and Information Technologies, 30(15), 22151–22176. https://doi.org/10.1007/s10639-025-13658-7
- Parry, D. A., Davidson, B. I., Sewall, C. J. R., Fisher, J. T., Mieczkowski, H. et Quintana, D. S. (2021). A systematic review and meta-analysis of discrepancies between logged and self-reported digital media use. Nature Human Behaviour, 5(11), 1535–1547. https://doi.org/10.1038/s41562-021-01117-5
- Straub, D., Limayem, M. et Karahanna-Evaristo, E. (1995). Measuring system usage: Implications for IS theory testing. Management Science, 41(8), 1328–1342. https://doi.org/10.1287/mnsc.41.8.1328
- Tang, Y. et Zhong, L. (2026). K-12 teachers’ adoption of generative AI for teaching: An extended TAM perspective. Education Sciences, 16(1), Article 136. https://doi.org/10.3390/educsci16010136
- Venkatesh, V., Morris, M. G., Davis, G. B. et Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425–478. https://doi.org/10.2307/30036540