Artículo · Investigación en educación
La aceptación no es el uso: qué miden las encuestas sobre la IA en la escuela
© Pablo Correa Prieto, 2026 — CC BY 4.0
Cuando una institución quiere saber si el profesorado usa la IA generativa, envía un cuestionario. Y ese cuestionario se construye casi siempre sobre el mismo modelo, el de la aceptación tecnológica. El problema no es el modelo. Es la distancia entre lo que mide y lo que se le pide que diga.
1.Lo que mide realmente el modelo
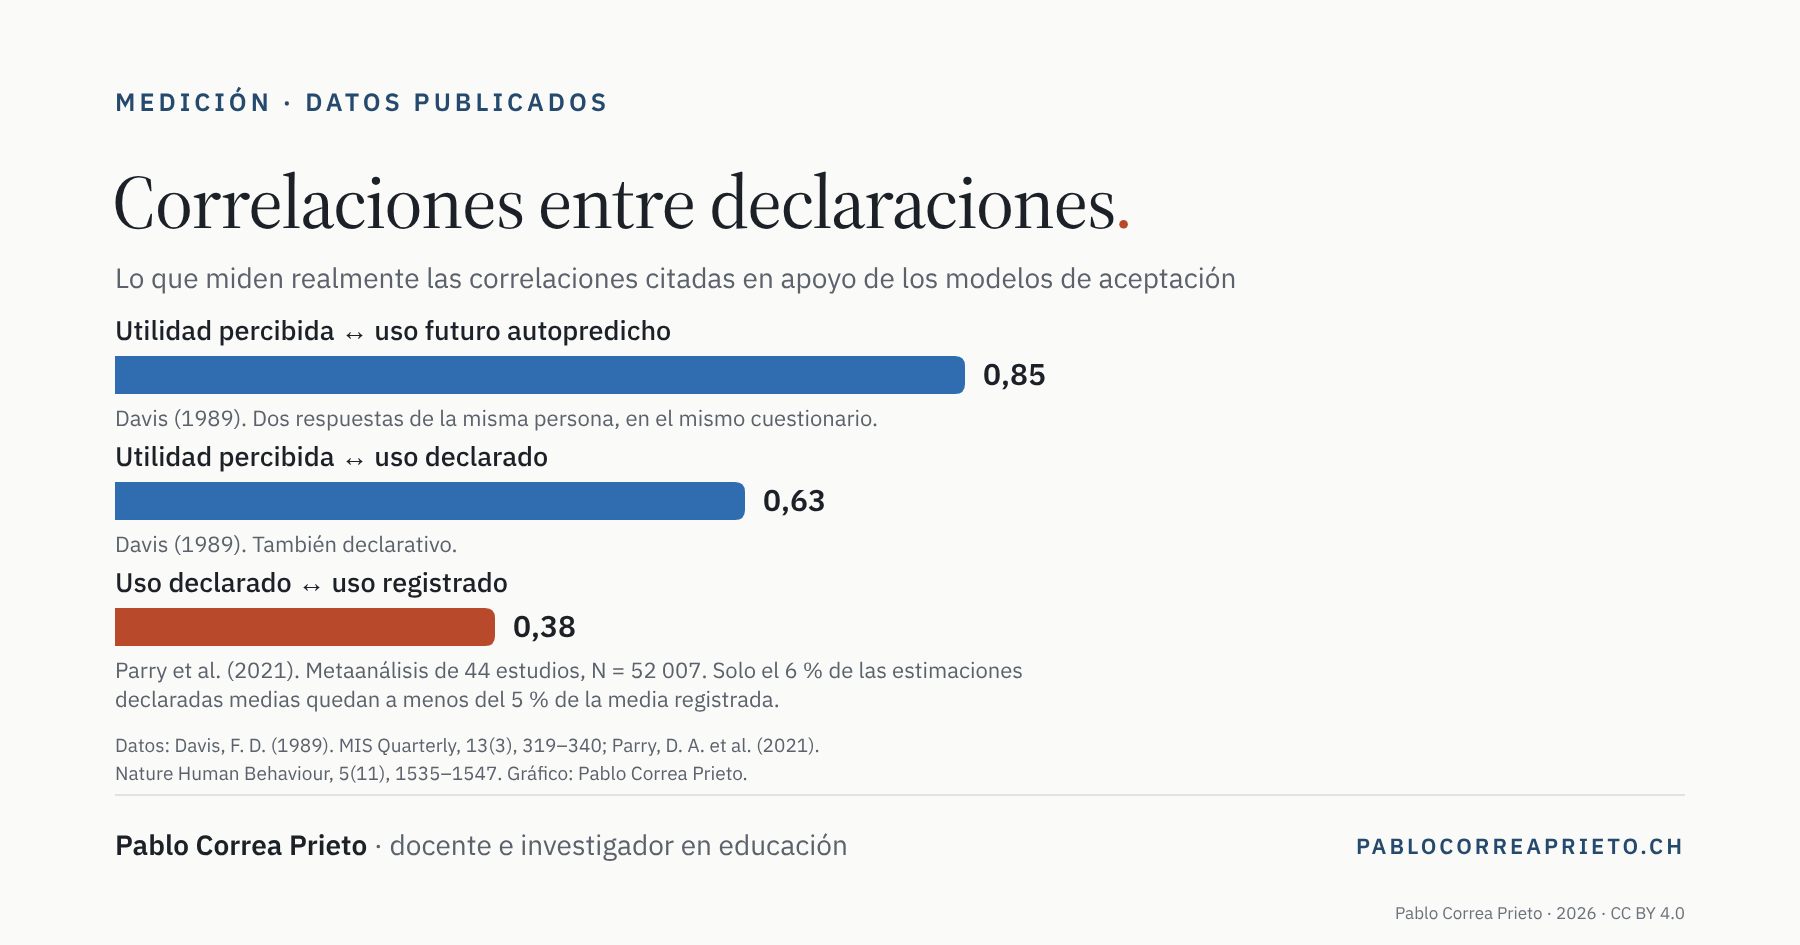
El artículo fundacional de esta corriente establece dos variables, la utilidad percibida y la facilidad de uso percibida, y las relaciona con el uso del sistema (Davis, 1989). Se informan dos correlaciones: 0,63 entre la utilidad percibida y el uso declarado por los participantes, y 0,85 entre la utilidad percibida y el uso futuro que los participantes se predecían a sí mismos.
Es la segunda cifra la que ha pasado a la posteridad, citada como prueba de que el modelo predice el uso. Conviene leerla por lo que es: una correlación entre dos respuestas dadas por la misma persona en el mismo cuestionario. No es una medida de comportamiento, es la coherencia interna de una declaración.
El modelo unificado que vino después informa de una varianza explicada del 69 % al 70 % (Venkatesh et al., 2003). Esa varianza se refiere a la intención de usar, no al uso. La distinción desaparece casi sistemáticamente cuando el resultado se repite.
© Pablo Correa Prieto, 2026 — CC BY 4.0
2.La distancia entre lo que se declara y lo que se hace
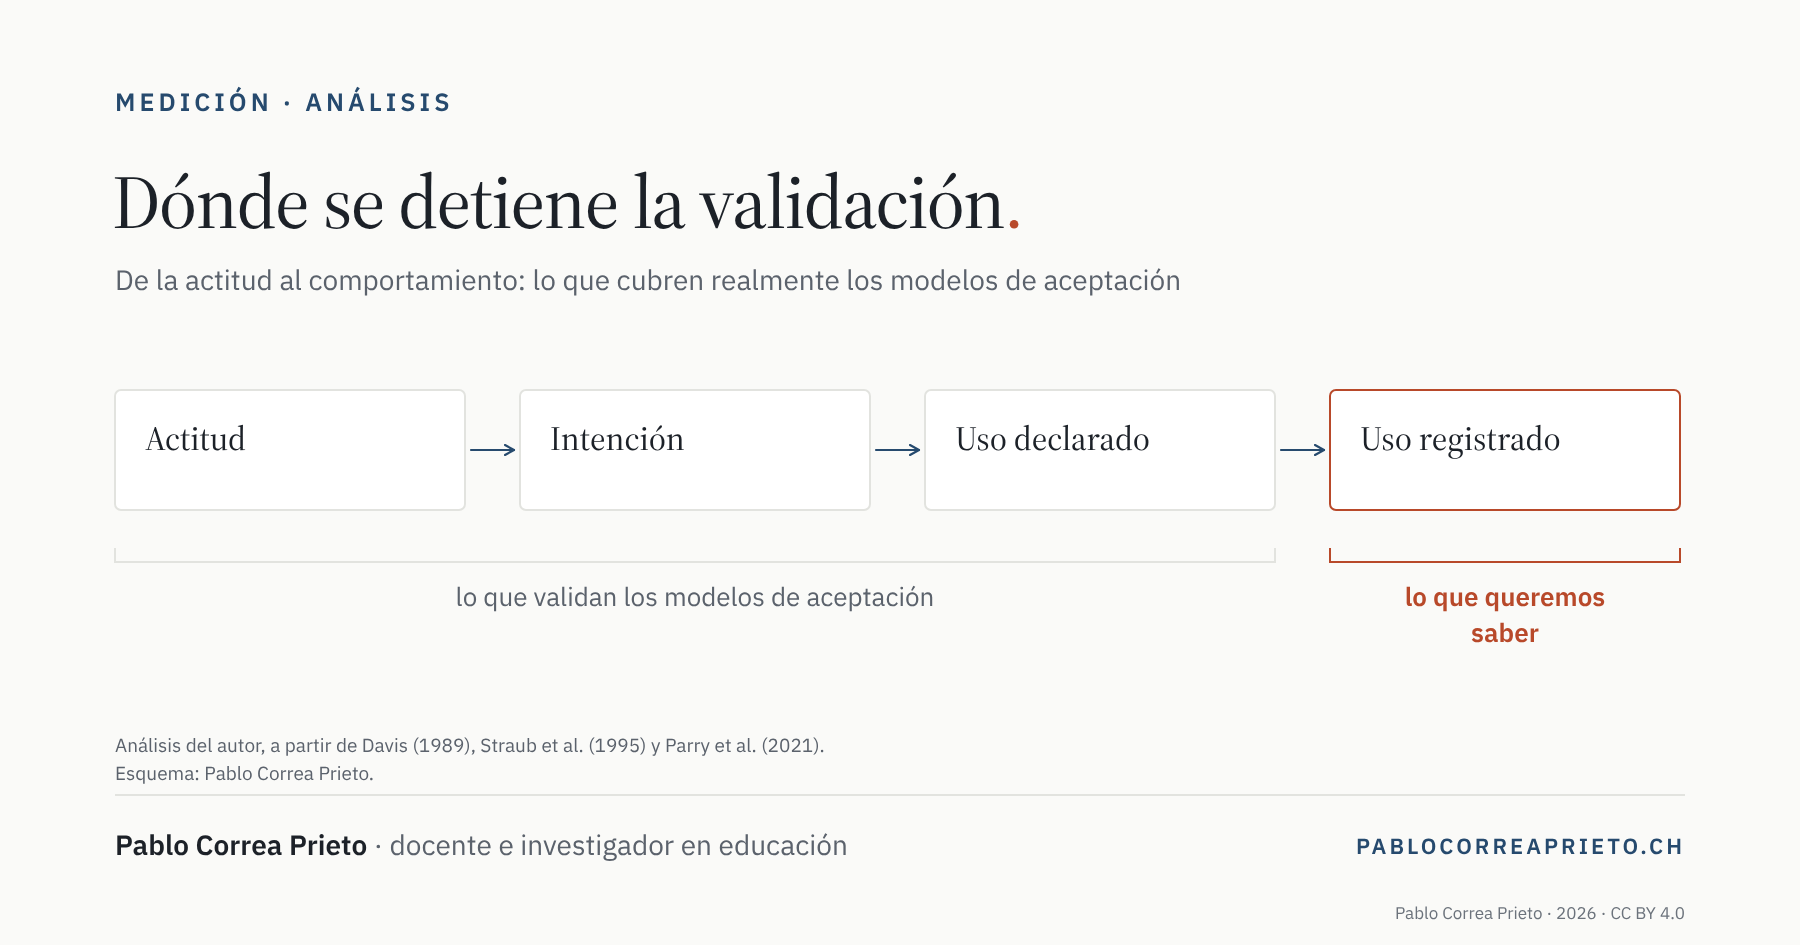
La cuestión se planteó pronto, y dentro de la misma literatura. Un estudio publicado en Management Science sostiene que el uso declarado y el uso registrado por la máquina son dos constructos distintos y que, en contra de lo esperado, no parecen estar fuertemente relacionados entre sí (Straub et al., 1995). Las medidas objetivas muestran vínculos claramente más débiles con las variables del modelo que las medidas declaradas. Los propios autores extraen la consecuencia: la investigación que confirma el modelo a partir de medidas subjetivas podría ser, según su término, artefactual.
Treinta años después, un metaanálisis publicado en Nature Human Behaviour reunió los estudios que comparan el uso declarado de un medio digital con su uso registrado (Parry et al., 2021). Sobre 44 estudios y más de 52 000 participantes, la correlación agregada es de 0,38. La declaración da cuenta, por tanto, de alrededor del 14 % de la varianza del uso real. Más elocuente aún: solo el 6 % de las estimaciones declaradas medias quedaban a menos del 5 % de la media registrada.
© Pablo Correa Prieto, 2026 — CC BY 4.0
Un detalle de ese metaanálisis merece atención. El sesgo no es sistemático, porque los participantes no sobrestiman de forma regular su uso y el intervalo de confianza de la razón entre lo declarado y lo registrado contiene el valor 1. Un sesgo constante podría corregirse. Un sesgo ruidoso no.
Un estudio más reciente encuentra el mismo perfil, con un resultado adicional (Coyne et al., 2023). Cuanto más se parece el instrumento a una escala de actitud, menos sigue al comportamiento registrado: las escalas de uso problemático, de nomofobia o de miedo a perderse algo correlacionaban entre 0,02 y 0,10 con los datos objetivos, mientras que una simple estimación de duración alcanzaba 0,51. La muestra estaba formada por adultos jóvenes y no por docentes, lo que limita el alcance de la cifra, pero el mecanismo es el que nos ocupa.
3.Las encuestas al profesorado hacen exactamente esto
Un estudio de 2026 con 218 docentes en activo de primaria y secundaria aplica un modelo de aceptación ampliado a la IA generativa (Tang y Zhong, 2026). La variable explicada es la intención de usar o de seguir usando la herramienta. No se recoge ningún dato de uso efectivo, pese a que la muestra está formada por docentes de los que una parte ya utiliza estas herramientas.
Un estudio en lengua alemana va algo más lejos y mide a la vez la intención y el uso (Dietrich y Grassini, 2025). Pero el uso es allí una frecuencia autodeclarada en una escala de siete puntos, recogida en el mismo instrumento que la intención. Su resultado más interesante afecta a los 56 docentes de la muestra: entre ellos desaparecen los predictores clásicos del modelo, y es el hábito el que predice el uso con tanta fuerza como la intención. La muestra es pequeña para el método empleado, y no la tomaría como una demostración. Pero la dirección es instructiva: en cuanto la variable explicada se acerca un poco al comportamiento, las variables de aceptación pierden su agarre.
4.Qué cambia esto para una encuesta cantonal
Una encuesta de aceptación informa sobre actitudes. Es una información real y útil, para decidir una oferta de formación o una comunicación. No dice lo que ocurre en las aulas, y tratarla como una cifra de uso es un error de lectura, no una aproximación.
Si la pregunta se refiere a la práctica, hacen falta huellas de práctica: preparaciones y materiales realmente producidos, entrevistas sobre las clases de la semana pasada en lugar de sobre intenciones, observación. Cada una de estas vías cuesta más que un cuestionario, y algunas están cerradas. Las recomendaciones de la Suiza romanda prohíben introducir producciones de alumnos en una herramienta de IA generativa mientras el cantón no proporcione una cuya fiabilidad esté garantizada (CIIP, 2025).
Nada de esto es un argumento contra los modelos de aceptación. Predicen correctamente lo que predicen, y la intención cuenta. Es un argumento contra una sustitución: leer una puntuación de aceptación como una tasa de uso.
Hablemos
Si usted dirige o lee este tipo de encuestas en la Suiza romanda, estaré encantado de comentarlo. Mis datos de contacto: pablocorreaprieto.ch
Texto redactado con ayuda de una IA, revisado y validado por el autor.
Referencias
- CIIP. (2025). Intelligence artificielle générative – IAG : recommandations pour une utilisation réfléchie et mesurée dans l’enseignement [Inteligencia artificial generativa: recomendaciones para un uso reflexivo y mesurado en la enseñanza]. Conférence intercantonale de l’instruction publique de la Suisse romande et du Tessin. https://www.ciip.ch/files/1050/Documents/IRDP/Recommandations_IAG_19-03-2025_V10.pdf
- Coyne, P., Voth, J. y Woodruff, S. J. (2023). A comparison of self-report and objective measurements of smartphone and social media usage. Telematics and Informatics Reports, 10, artículo 100061. https://doi.org/10.1016/j.teler.2023.100061
- Davis, F. D. (1989). Perceived usefulness, perceived ease of use, and user acceptance of information technology. MIS Quarterly, 13(3), 319–340. https://doi.org/10.2307/249008
- Dietrich, L. K. y Grassini, S. (2025). Assessing ChatGPT acceptance and use in education: A comparative study among german-speaking students and teachers. Education and Information Technologies, 30(15), 22151–22176. https://doi.org/10.1007/s10639-025-13658-7
- Parry, D. A., Davidson, B. I., Sewall, C. J. R., Fisher, J. T., Mieczkowski, H. y Quintana, D. S. (2021). A systematic review and meta-analysis of discrepancies between logged and self-reported digital media use. Nature Human Behaviour, 5(11), 1535–1547. https://doi.org/10.1038/s41562-021-01117-5
- Straub, D., Limayem, M. y Karahanna-Evaristo, E. (1995). Measuring system usage: Implications for IS theory testing. Management Science, 41(8), 1328–1342. https://doi.org/10.1287/mnsc.41.8.1328
- Tang, Y. y Zhong, L. (2026). K-12 teachers’ adoption of generative AI for teaching: An extended TAM perspective. Education Sciences, 16(1), artículo 136. https://doi.org/10.3390/educsci16010136
- Venkatesh, V., Morris, M. G., Davis, G. B. y Davis, F. D. (2003). User acceptance of information technology: Toward a unified view. MIS Quarterly, 27(3), 425–478. https://doi.org/10.2307/30036540