Article · L’IA et l’évaluation
Détecter l’IA dans une copie : pourquoi la fiabilité n’est pas la bonne question
© Pablo Correa Prieto, 2026 — CC BY 4.0
Un texte arrive qui ne ressemble pas à l’élève. Le vocabulaire est trop sûr, les phrases trop régulières, et l’enseignant a le sentiment, difficile à formuler, que ce n’est pas lui qui l’a écrit. Le réflexe est de chercher un outil qui tranchera. C’est ce réflexe que je voudrais discuter, non pas parce que les détecteurs seraient mauvais, puisqu’ils se sont nettement améliorés, mais à cause de la nature de leur réponse.
1.Ce que les outils ont montré entre 2023 et 2024
OpenAI a publié son propre classificateur le 31 janvier 2023, puis l’a retiré le 20 juillet de la même année, en indiquant sur la page même la raison : une exactitude trop faible. Les chiffres annoncés par l’entreprise méritent d’être rappelés. L’outil identifiait correctement 26 % des textes produits par une IA, et signalait à tort 9 % des textes écrits par des humains (OpenAI, 2023).
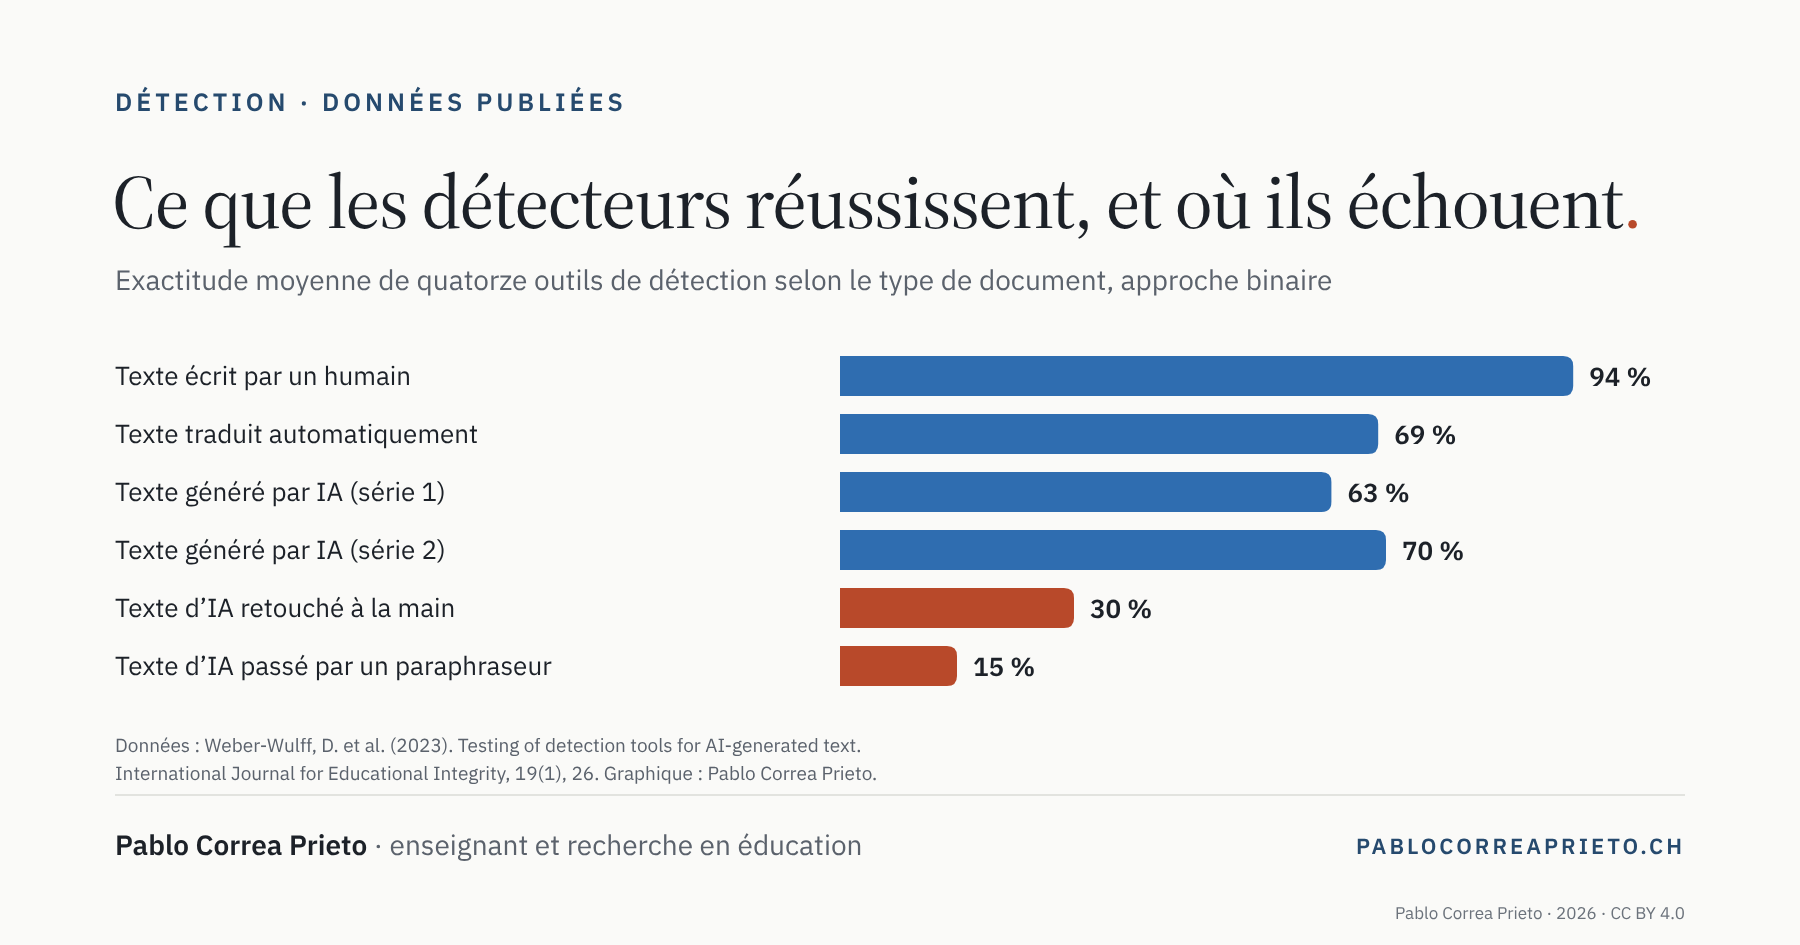
La même année, une équipe internationale a testé quatorze outils de détection sur cinquante-quatre cas préparés pour l’occasion (Weber-Wulff et al., 2023). Aucun n’atteignait 80 % d’exactitude. En approche binaire, l’exactitude moyenne tombait à 30 % sur un texte d’IA retouché à la main et à 15 % sur un texte d’IA passé par un paraphraseur automatique. Le taux moyen de fausse accusation était de 2,4 % sur des textes humains, montait à 11,1 % sur des textes traduits automatiquement, et atteignait 50 % pour un outil en particulier. La conclusion des auteurs est explicite : ces systèmes ne devraient pas être utilisés en contexte académique.
© Pablo Correa Prieto, 2026 — CC BY 4.0
Un texte paru la même année dans Patterns, présenté par la revue comme une opinion et non comme un article de recherche, ajoutait une inégalité. Sept détecteurs appliqués à 91 essais écrits par des candidats non anglophones en signalaient en moyenne environ 61 % comme produits par une IA, contre environ 5 % pour des essais d’élèves américains (Liang et al., 2023). Demander à un modèle de reformuler ces mêmes essais dans une langue plus idiomatique faisait tomber le taux à environ 12 %.
Un an plus tard, une autre équipe montrait que des manipulations très simples suffisent à faire chuter la détection (Perkins et al., 2024). L’exactitude moyenne passait de 39,5 % sur du contenu d’IA non modifié à 22,1 % après manipulation. Les techniques les plus efficaces étaient, dans l’ordre, l’ajout de fautes d’orthographe, l’augmentation de l’irrégularité du texte, puis la paraphrase.
2.Mais la situation a changé, et il faut le dire
S’arrêter là serait commode et malhonnête. Une étude de 2026 a testé quatre détecteurs sur 160 documents dont l’origine était connue (Van Vlasselaer et al., 2026). Les quatre outils ont classé correctement 100 % des textes humains, et les auteurs notent que les faux positifs sont désormais rares, contrairement à ce que montraient les travaux antérieurs. Sur des textes hybrides ou retouchés pour paraître humains, l’outil le plus performant atteignait 92,5 % d’exactitude.
Autrement dit, l’argument « les détecteurs se trompent trop » est en train de se périmer. Ne citer que les travaux de 2023 serait choisir ses sources. Et pourtant les mêmes auteurs concluent que ces outils ne devraient pas servir de preuve unique dans une décision à fort enjeu. C’est cette conclusion qui m’intéresse, parce qu’elle ne dépend pas du niveau de performance atteint.
3.Un bon détecteur ne règle pas le problème
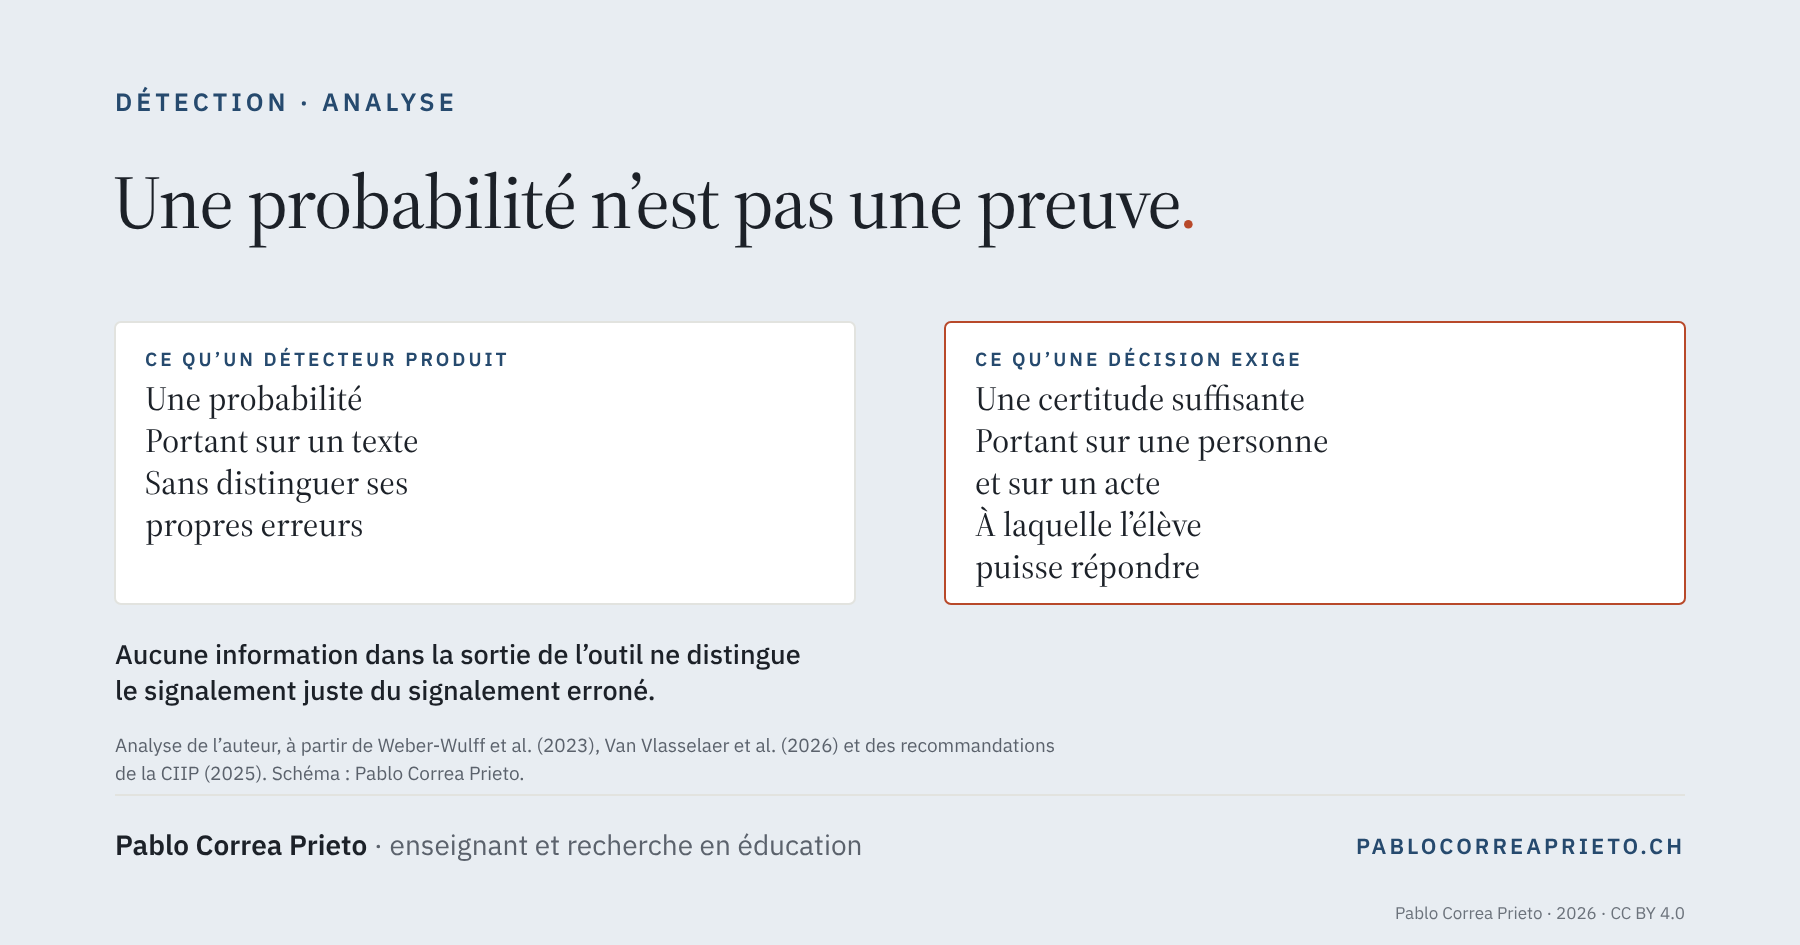
Un détecteur produit une probabilité portant sur un texte. Une décision disciplinaire porte sur une personne et sur un acte. Entre les deux, il manque quelque chose que l’outil ne peut pas fournir, quelle que soit son exactitude.
Le raisonnement est simple, et c’est un raisonnement, pas un résultat d’étude. Supposons un outil excellent, qui ne se trompe que très rarement sur un texte humain. Appliqué à une série de copies dont une petite partie seulement a été produite par une IA, il produira malgré tout quelques signalements erronés. Le problème n’est pas leur nombre. C’est qu’aucune information dans la sortie de l’outil ne distingue le signalement juste du signalement erroné. C’est précisément ce que signifie une probabilité.
Du côté de l’élève, la situation est pire. À qui on demande de prouver qu’il a écrit son texte, un élève honnête n’a rien à produire. Il n’existe pas de preuve d’absence. La charge de la preuve se retrouve du mauvais côté, sur la personne la moins outillée pour y répondre.
Les recommandations romandes disent la même chose en une phrase : les outils de détection, basés eux aussi sur des méthodes probabilistes, ne sont pas en mesure d’évaluer de manière fiable si une IA générative a été utilisée (CIIP, 2025).
© Pablo Correa Prieto, 2026 — CC BY 4.0
4.Déplacer la question plutôt que la trancher
Si la détection ne peut pas fonder une décision, il faut concevoir les tâches pour que la question se pose autrement. Trois pistes me paraissent solides.
- Nommer les règles avant, pas après. La CIIP propose un contrat pédagogique entre l’enseignant et les élèves, qui définit les usages admis, la transparence attendue et ce qui constitue une tricherie. Une règle énoncée à l’avance n’a pas besoin d’un détecteur pour être appliquée.
- Évaluer ce qui se vérifie. Non pas « ce texte a-t-il été écrit par une IA ? », mais « cet élève maîtrise-t-il ce qu’il a rendu ? ». La directive sur les évaluations certificatives de la HEP Vaud prévoit un mécanisme de ce type : le jury peut convoquer l’étudiant pour un oral portant sur un bref extrait de son propre travail, choisi par le jury, et conclut en principe à l’échec si l’étudiant ne démontre pas la cohérence et l’exactitude de cet extrait (HEP Vaud, 2025). La question devient vérifiable, et l’élève peut y répondre.
- Déplacer le poids vers le processus. C’est la recommandation explicite de la CIIP pour l’évaluation : recentrer sur la démarche plutôt que sur le seul produit fini, et accepter que dans un travail à domicile, interdire l’outil est impossible.
Aucune de ces pistes n’est confortable. Elles demandent plus de temps qu’un bouton qui renvoie un pourcentage. Mais elles portent sur des questions auxquelles un élève peut répondre, ce qui n’est pas le cas de la première.
Échangeons
Comment traitez-vous, dans votre établissement, le texte qui ne ressemble pas à l’élève ? Je serai heureux d’en discuter. Mes coordonnées : pablocorreaprieto.ch
Texte rédigé avec l’aide d’une IA, relu et validé par l’auteur.
Références
- CIIP. (2025). Intelligence artificielle générative – IAG : recommandations pour une utilisation réfléchie et mesurée dans l’enseignement. Conférence intercantonale de l’instruction publique de la Suisse romande et du Tessin. https://www.ciip.ch/files/1050/Documents/IRDP/Recommandations_IAG_19-03-2025_V10.pdf
- HEP Vaud. (2025). Directive 05_05 : Évaluations certificatives (état au 21 novembre 2025). Haute école pédagogique du canton de Vaud. https://www.hepl.ch/files/live/sites/files-site/files/comite-direction/directives/directive-05-05-evaluations-certificatives-5dec23.pdf
- Liang, W., Yuksekgonul, M., Mao, Y., Wu, E. et Zou, J. (2023). GPT detectors are biased against non-native English writers [opinion]. Patterns, 4(7), Article 100779. https://doi.org/10.1016/j.patter.2023.100779
- OpenAI. (2023, 31 janvier). New AI classifier for indicating AI-written text. https://openai.com/index/new-ai-classifier-for-indicating-ai-written-text/
- Perkins, M., Roe, J., Vu, B. H., Postma, D., Hickerson, D., McGaughran, J. et Khuat, H. Q. (2024). Simple techniques to bypass GenAI text detectors: Implications for inclusive education. International Journal of Educational Technology in Higher Education, 21, Article 53. https://doi.org/10.1186/s41239-024-00487-w
- Van Vlasselaer, M., Van Droogenbroeck, F. et Spruyt, B. (2026). Who wrote this? Evaluating the reliability of AI detection tools in higher education. International Journal for Educational Integrity, 22(1), Article 16. https://doi.org/10.1007/s40979-026-00226-w
- Weber-Wulff, D., Anohina-Naumeca, A., Bjelobaba, S., Foltýnek, T., Guerrero-Dib, J., Popoola, O., Šigut, P. et Waddington, L. (2023). Testing of detection tools for AI-generated text. International Journal for Educational Integrity, 19(1), Article 26. https://doi.org/10.1007/s40979-023-00146-z