Artículo · La IA y la evaluación
Detectar la IA en un trabajo: por qué la fiabilidad no es la cuestión
© Pablo Correa Prieto, 2026 — CC BY 4.0
Llega un texto que no se parece al alumno. El vocabulario es demasiado seguro, las frases demasiado regulares, y el docente tiene la sensación, difícil de formular, de que no lo ha escrito él. El reflejo es buscar una herramienta que zanje la cuestión. Es ese reflejo lo que quiero discutir, no porque los detectores sean malos, ya que han mejorado notablemente, sino por la naturaleza de su respuesta.
1.Lo que mostraron las herramientas entre 2023 y 2024
OpenAI publicó su propio clasificador el 31 de enero de 2023 y lo retiró el 20 de julio del mismo año, indicando en la propia página el motivo: una exactitud demasiado baja. Conviene recordar las cifras anunciadas por la empresa. La herramienta identificaba correctamente el 26 % de los textos producidos por una IA y señalaba erróneamente el 9 % de los textos escritos por personas (OpenAI, 2023).
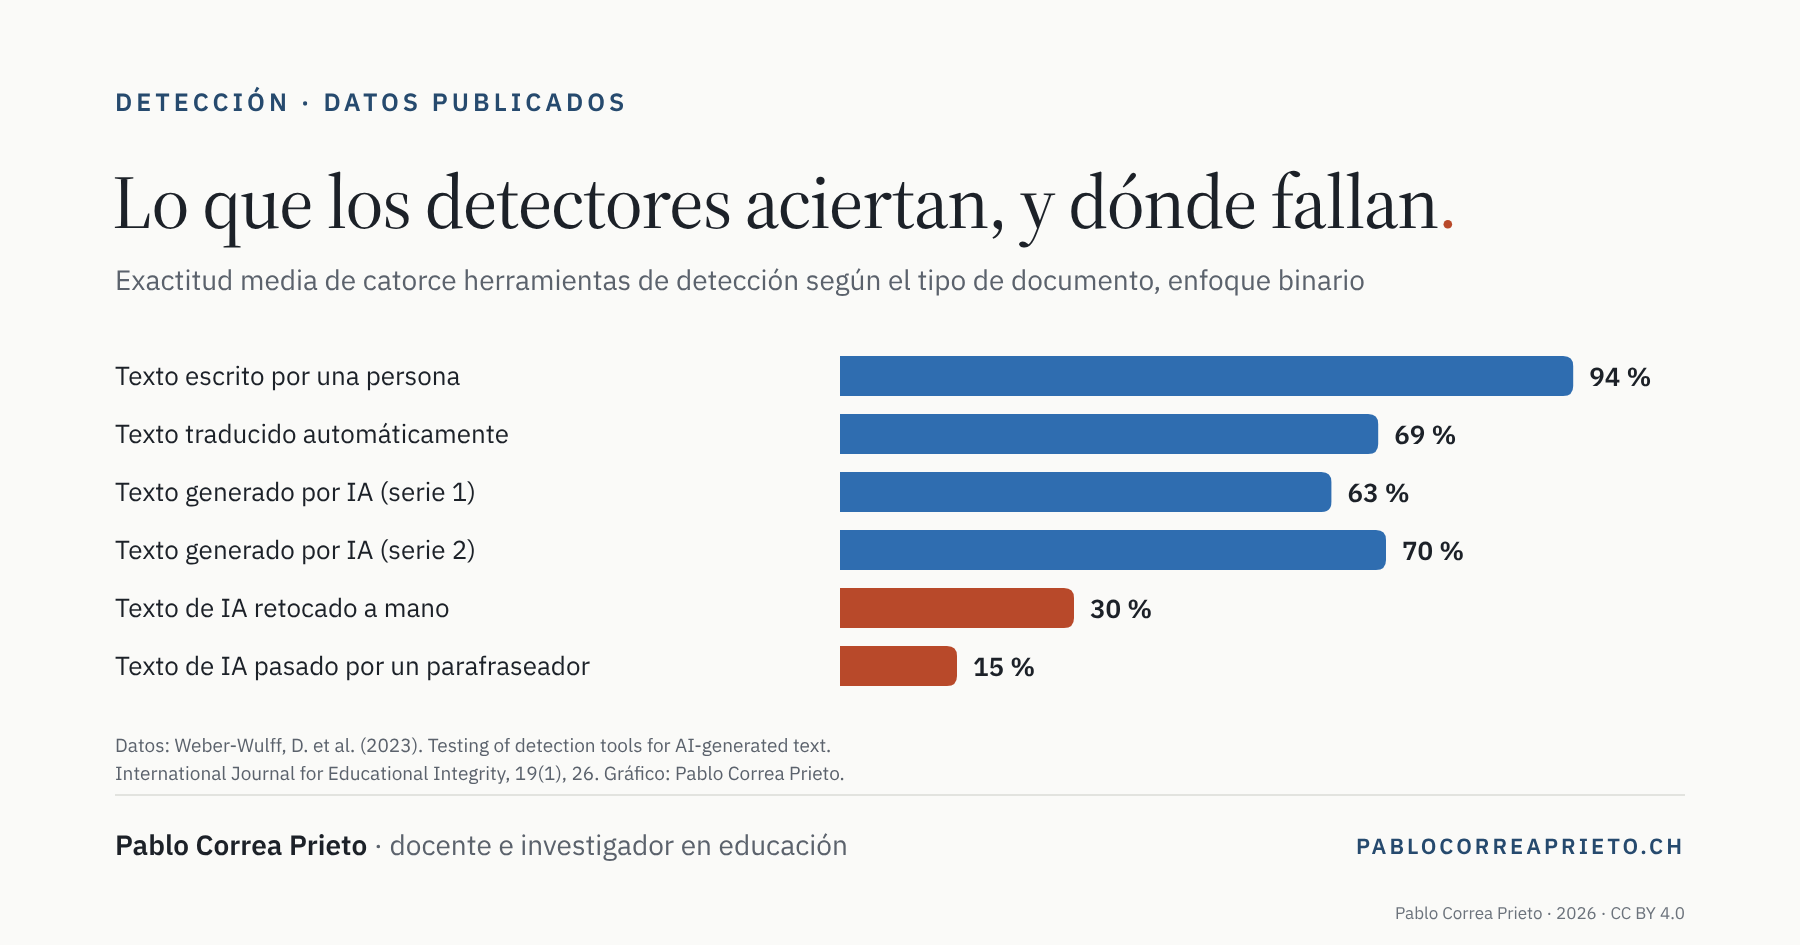
Ese mismo año, un equipo internacional probó catorce herramientas de detección sobre cincuenta y cuatro casos preparados al efecto (Weber-Wulff et al., 2023). Ninguna alcanzaba el 80 % de exactitud. Con el enfoque binario, la exactitud media caía al 30 % en un texto de IA retocado a mano y al 15 % en un texto de IA pasado por un parafraseador automático. La tasa media de falsa acusación era del 2,4 % en textos humanos, subía al 11,1 % en textos traducidos automáticamente y alcanzaba el 50 % en una herramienta concreta. La conclusión de los autores es explícita: estos sistemas no deberían usarse en contextos académicos.
© Pablo Correa Prieto, 2026 — CC BY 4.0
Un texto publicado ese mismo año en Patterns, que la revista presenta como una opinión y no como un artículo de investigación, añadía una desigualdad. Siete detectores aplicados a 91 redacciones escritas por candidatos no anglófonos señalaban de media en torno al 61 % como producidas por una IA, frente a alrededor del 5 % en redacciones de escolares estadounidenses (Liang et al., 2023). Pedir a un modelo que reformulara esas mismas redacciones en un inglés más idiomático hacía bajar la tasa hasta cerca del 12 %.
Un año después, otro equipo mostraba que manipulaciones muy simples bastan para hundir la detección (Perkins et al., 2024). La exactitud media pasaba del 39,5 % en contenido de IA sin modificar al 22,1 % tras la manipulación. Las técnicas más eficaces eran, por este orden, añadir faltas de ortografía, aumentar la irregularidad del texto y después parafrasear.
2.Pero la situación ha cambiado, y hay que decirlo
Detenerse ahí sería cómodo y deshonesto. Un estudio de 2026 probó cuatro detectores sobre 160 documentos de origen conocido (Van Vlasselaer et al., 2026). Las cuatro herramientas clasificaron correctamente el 100 % de los textos humanos, y los autores señalan que los falsos positivos son ya poco frecuentes, a diferencia de lo que mostraban los trabajos anteriores. En textos híbridos o retocados para parecer humanos, la herramienta más eficaz alcanzaba el 92,5 % de exactitud.
Dicho de otro modo, el argumento de que los detectores se equivocan demasiado está quedando obsoleto. Citar solo los trabajos de 2023 sería elegir las fuentes. Y sin embargo, esos mismos autores concluyen que estas herramientas no deberían servir como prueba única en una decisión de alto riesgo. Es esa conclusión la que me interesa, porque no depende del nivel de rendimiento alcanzado.
3.Un buen detector no resuelve el problema
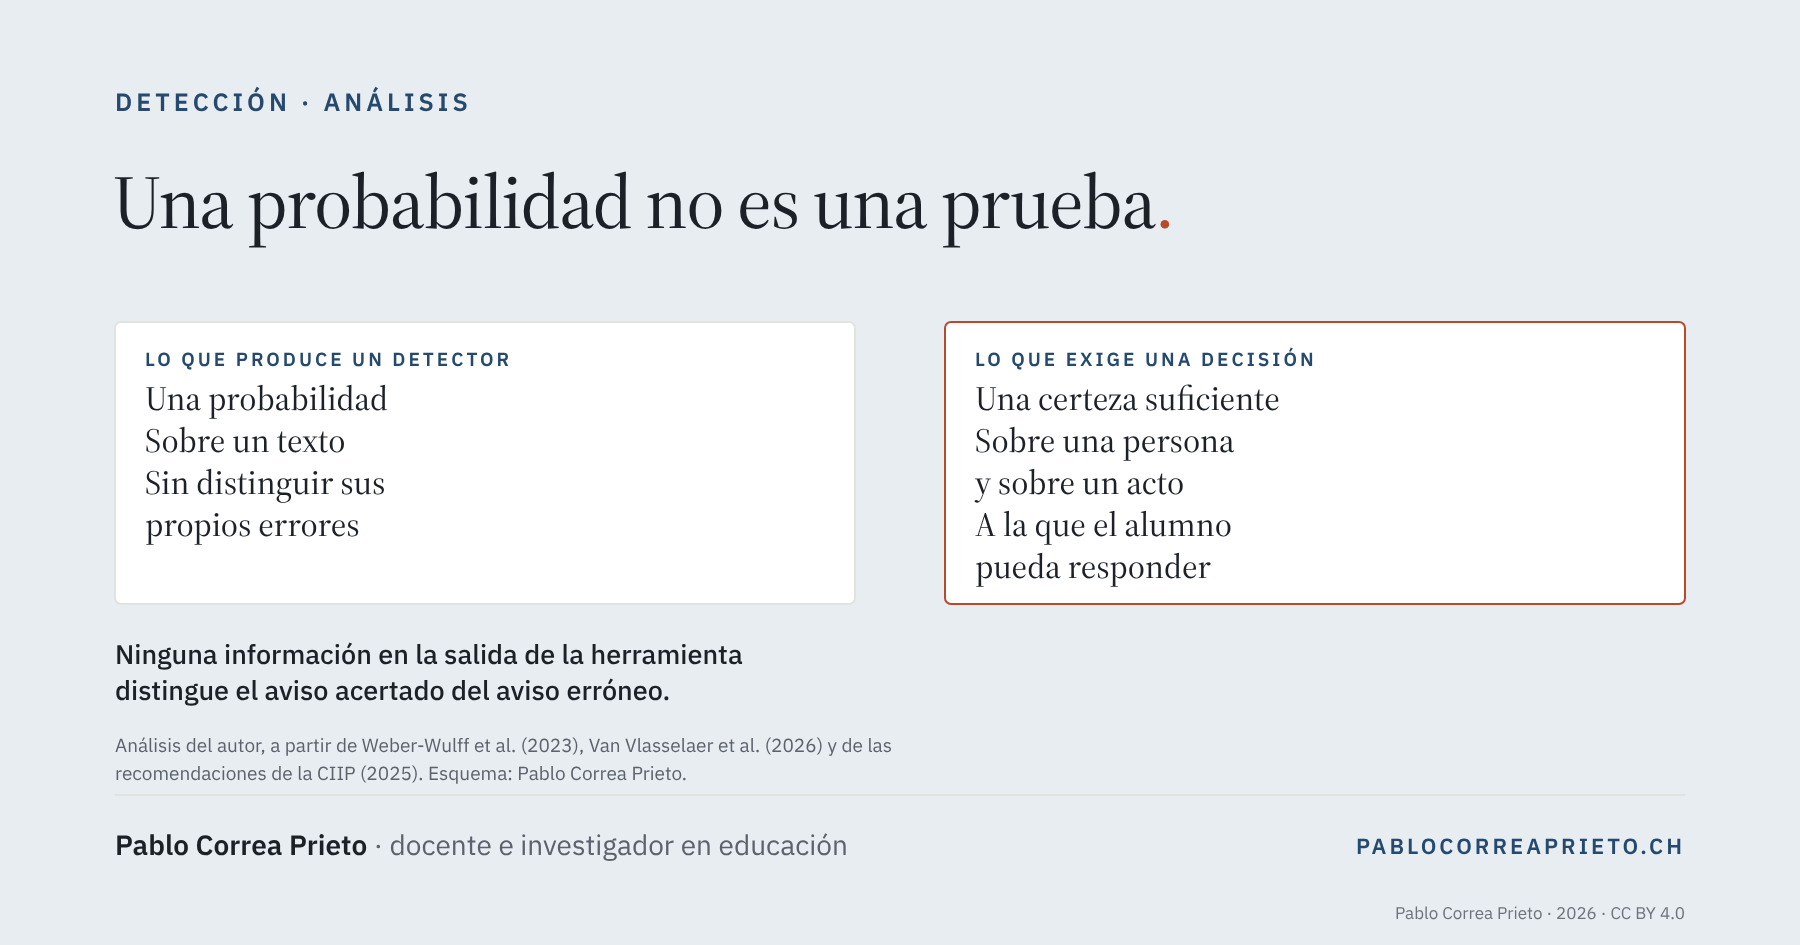
Un detector produce una probabilidad sobre un texto. Una decisión disciplinaria recae sobre una persona y sobre un acto. Entre ambas cosas falta algo que la herramienta no puede aportar, sea cual sea su exactitud.
El razonamiento es sencillo, y es un razonamiento, no el resultado de un estudio. Supongamos una herramienta excelente, que solo muy rara vez se equivoca con un texto humano. Aplicada a una serie de trabajos de los que solo una pequeña parte ha sido producida por una IA, producirá aun así algunos avisos erróneos. El problema no es cuántos. Es que ninguna información en la salida de la herramienta distingue el aviso acertado del aviso erróneo. Eso es precisamente lo que significa una probabilidad.
Del lado del alumno, la situación es peor. A quien se le pide que demuestre que ha escrito su texto, un alumno honesto no tiene nada que presentar. No existe prueba de ausencia. La carga de la prueba acaba del lado equivocado, en la persona menos equipada para responder.
Las recomendaciones de la Suiza romanda dicen lo mismo en una frase: las herramientas de detección, basadas también en métodos probabilísticos, no están en condiciones de evaluar de manera fiable si se ha utilizado una IA generativa (CIIP, 2025).
© Pablo Correa Prieto, 2026 — CC BY 4.0
4.Desplazar la pregunta en lugar de zanjarla
Si la detección no puede fundamentar una decisión, hay que diseñar las tareas para que la pregunta se plantee de otro modo. Tres vías me parecen sólidas.
- Nombrar las reglas antes, no después. La CIIP propone un contrato pedagógico entre el docente y los alumnos, que define los usos admitidos, la transparencia esperada y lo que constituye copiar. Una regla enunciada de antemano no necesita un detector para aplicarse.
- Evaluar lo que se puede comprobar. No «¿ha escrito este texto una IA?», sino «¿domina este alumno lo que ha entregado?». La directiva sobre evaluaciones certificativas de la HEP Vaud prevé un mecanismo de este tipo: el tribunal puede convocar al estudiante a un oral sobre un breve fragmento de su propio trabajo, elegido por el tribunal, y concluye en principio con el suspenso si el estudiante no demuestra la coherencia y la exactitud de ese fragmento (HEP Vaud, 2025). La pregunta pasa a ser comprobable, y el alumno puede responderla.
- Desplazar el peso hacia el proceso. Es la recomendación explícita de la CIIP para la evaluación: volver a centrarse en el procedimiento más que en el producto acabado, y aceptar que en un trabajo para casa prohibir la herramienta es imposible.
Ninguna de estas vías es cómoda. Exigen más tiempo que un botón que devuelve un porcentaje. Pero se refieren a preguntas que un alumno puede responder, cosa que no ocurre con la primera.
Hablemos
¿Cómo se trata en su centro el texto que no se parece al alumno? Estaré encantado de comentarlo. Mis datos de contacto: pablocorreaprieto.ch
Texto redactado con ayuda de una IA, revisado y validado por el autor.
Referencias
- CIIP. (2025). Intelligence artificielle générative – IAG : recommandations pour une utilisation réfléchie et mesurée dans l’enseignement [Inteligencia artificial generativa: recomendaciones para un uso reflexivo y mesurado en la enseñanza]. Conférence intercantonale de l’instruction publique de la Suisse romande et du Tessin. https://www.ciip.ch/files/1050/Documents/IRDP/Recommandations_IAG_19-03-2025_V10.pdf
- HEP Vaud. (2025). Directive 05_05 : Évaluations certificatives [Directiva 05_05: evaluaciones certificativas] (estado a 21 de noviembre de 2025). Haute école pédagogique du canton de Vaud. https://www.hepl.ch/files/live/sites/files-site/files/comite-direction/directives/directive-05-05-evaluations-certificatives-5dec23.pdf
- Liang, W., Yuksekgonul, M., Mao, Y., Wu, E. y Zou, J. (2023). GPT detectors are biased against non-native English writers [opinión]. Patterns, 4(7), artículo 100779. https://doi.org/10.1016/j.patter.2023.100779
- OpenAI. (2023, 31 de enero). New AI classifier for indicating AI-written text. https://openai.com/index/new-ai-classifier-for-indicating-ai-written-text/
- Perkins, M., Roe, J., Vu, B. H., Postma, D., Hickerson, D., McGaughran, J. y Khuat, H. Q. (2024). Simple techniques to bypass GenAI text detectors: Implications for inclusive education. International Journal of Educational Technology in Higher Education, 21, artículo 53. https://doi.org/10.1186/s41239-024-00487-w
- Van Vlasselaer, M., Van Droogenbroeck, F. y Spruyt, B. (2026). Who wrote this? Evaluating the reliability of AI detection tools in higher education. International Journal for Educational Integrity, 22(1), artículo 16. https://doi.org/10.1007/s40979-026-00226-w
- Weber-Wulff, D., Anohina-Naumeca, A., Bjelobaba, S., Foltýnek, T., Guerrero-Dib, J., Popoola, O., Šigut, P. y Waddington, L. (2023). Testing of detection tools for AI-generated text. International Journal for Educational Integrity, 19(1), artículo 26. https://doi.org/10.1007/s40979-023-00146-z