Artículo · La IA y la evaluación
Corregir con IA: compararla con nuestros errores reales, no con la perfección
© Pablo Correa Prieto, 2026 — CC BY 4.0
En un artículo anterior escribí que solemos comparar la IA con un ideal sin errores, cuando la comparación honesta es con nuestra propia manera de corregir. Esa afirmación necesita pruebas. Para saber cuánto vale una herramienta que ayuda a corregir, primero hay que saber cuánto vale la corrección humana. Sobre esto, la investigación es antigua, abundante y poco halagadora para nosotros.
1.El mismo examen, notas muy distintas
En 1912, Daniel Starch y Edward Elliott enviaron los mismos dos exámenes de inglés a doscientos institutos estadounidenses; 142 docentes los corrigieron. Cuando se les preguntaba, los docentes solían estimar que dos correctores no se separarían en más de 10 puntos. En realidad, las notas de un mismo examen podían repartirse en 35 a 40 puntos, y en uno de los dos exámenes, 22 de los 142 docentes no le dieron el aprobado (Starch y Elliott, 1912). Al año siguiente repitieron la experiencia en geometría: las notas estaban aún más dispersas que en inglés. Su conclusión interpela directamente al profesorado de matemáticas: no hay razón para pensar que un examen de matemáticas se corrija con más precisión que cualquier otro (Starch y Elliott, 1913).
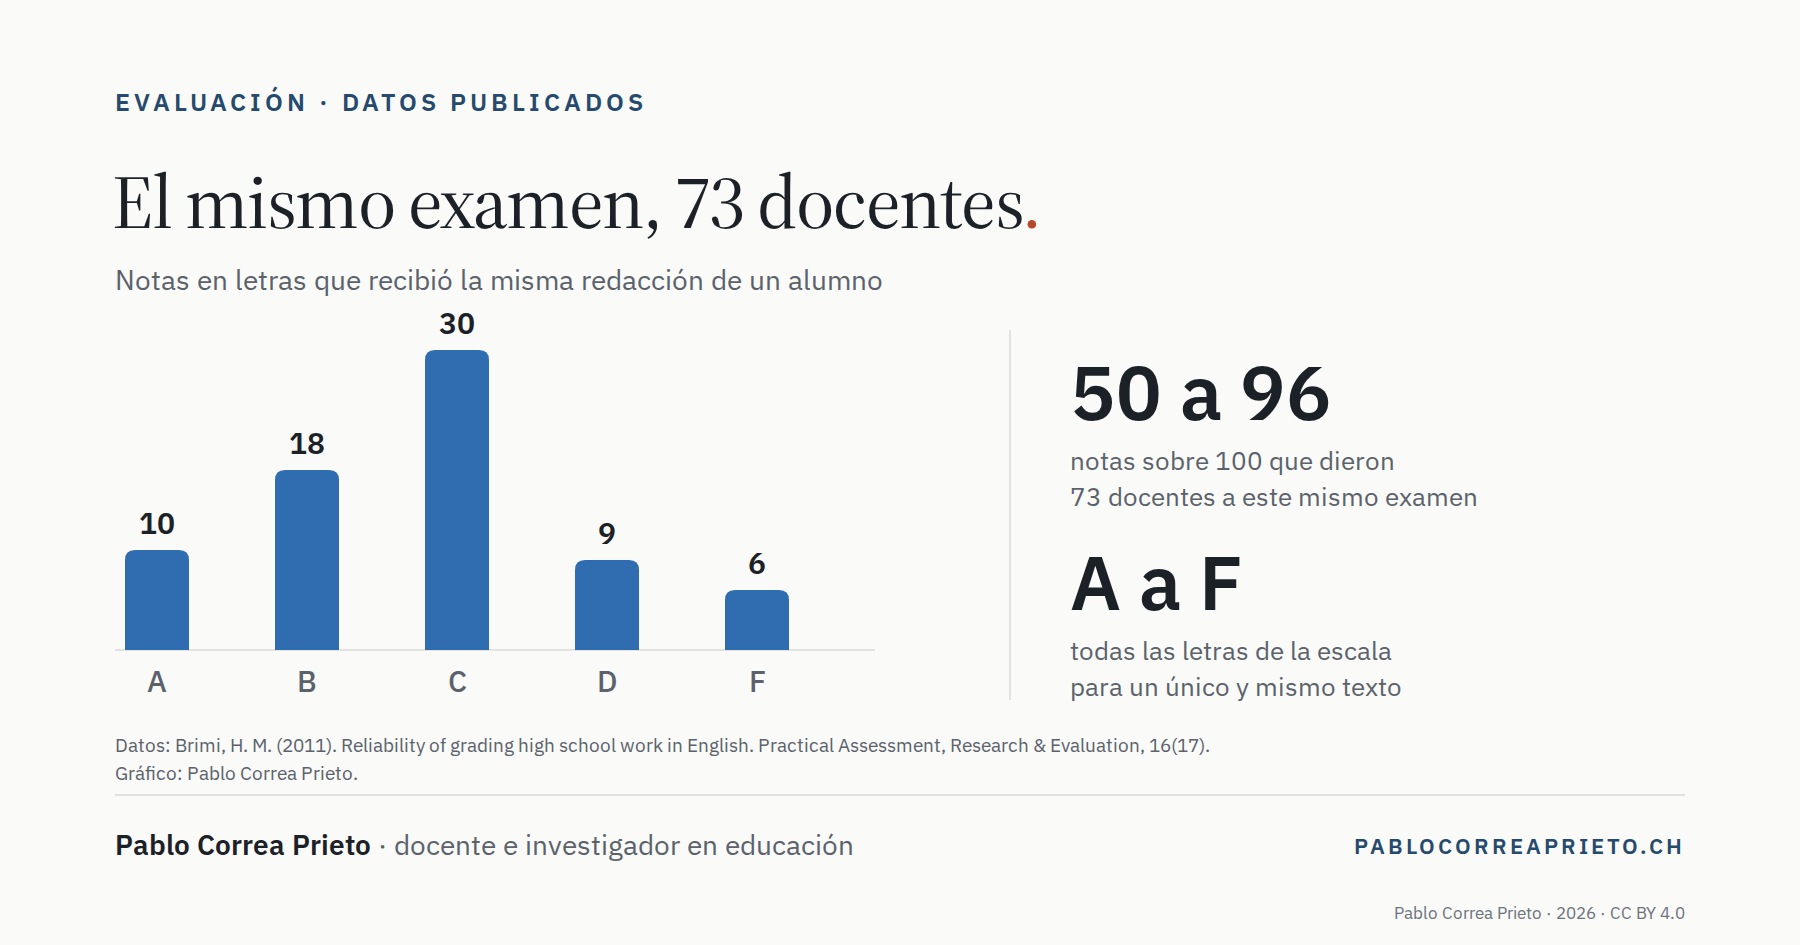
Casi un siglo después, Hunter Brimi (2011) retomó la pregunta con 90 docentes de secundaria que corrigieron la misma redacción. Entre los 73 que puntuaron sobre 100, las notas fueron de 50 a 96. En letras, el mismo texto recibió 10 A, 18 B, 30 C, 9 D y 6 F.
© Pablo Correa Prieto, 2026 — CC BY 4.0
2.El orden de los exámenes y la duración de la sesión cuentan
Hablaba del cansancio al final del montón. Klein y El (2003) dieron las mismas 31 redacciones de alumnos de séptimo curso a 60 profesoras, en tres órdenes distintos. A medida que avanzaban en el montón, las notas subían poco a poco, hasta superar las de correctores especializados; entre los primeros y los últimos exámenes, la diferencia rondaba el 10 %. Los autores relacionan esta deriva con las sesiones largas de corrección sin pausa.
El orden actúa también de otra forma: docentes en formación puntuaron más bajo dos redacciones medias cuando seguían a cinco buenas que cuando seguían a cinco malas (Hales y Tokar, 1975, citados en Meadows y Billington, 2005). La misma revisión menciona, sin embargo, un estudio sobre la corrección de exámenes que no encuentra un efecto importante del momento en que se corrige cada examen. El efecto no es siempre el mismo; pero nuestra nota depende en parte de lo que acabamos de leer.
A esto se suma lo que cualquier docente conoce: un criterio aplicado con más manga ancha en el trigésimo examen que en el tercero, una errata en un enunciado que solo vemos cuando ya hemos devuelto los exámenes. Nada de esto es una falta profesional. Es el funcionamiento normal de un corrector humano.
3.Lo que dicen los primeros estudios sobre la IA
Frente a esta referencia, los grandes modelos de lenguaje no son ni perfectos ni inútiles. Sobre 1710 respuestas cortas de alumnos de 5 a 16 años en ciencias e historia, que había que juzgar como correctas o incorrectas, GPT-4 alcanzó un acuerdo de 0,70 (kappa de Cohen) con el profesorado, frente a 0,75 entre los propios docentes (Henkel et al., 2024). Sobre 20 redacciones de alumnos de 7.º y 8.º curso, puntuadas por 37 docentes según diez criterios, el mejor modelo probado obtuvo una correlación de 0,74 con las notas del profesorado; pero puntuaba con más generosidad y captaba peor la calidad del contenido (Seßler et al., 2025). En los comentarios escritos sobre textos de alumnos, evaluadores humanos formados lo hicieron mejor que ChatGPT 3.5 en todas las categorías salvo una, la adecuación a los criterios (Steiss et al., 2024).
Mi lectura de estos resultados: la IA todavía no es un corrector fiable por sí sola, sobre todo cuando hay que juzgar el fondo de un texto. Pero la distancia con un corrector humano es mucho menor de lo que parece cuando se la compara con la perfección.
4.Una segunda mirada, no un corrector automático
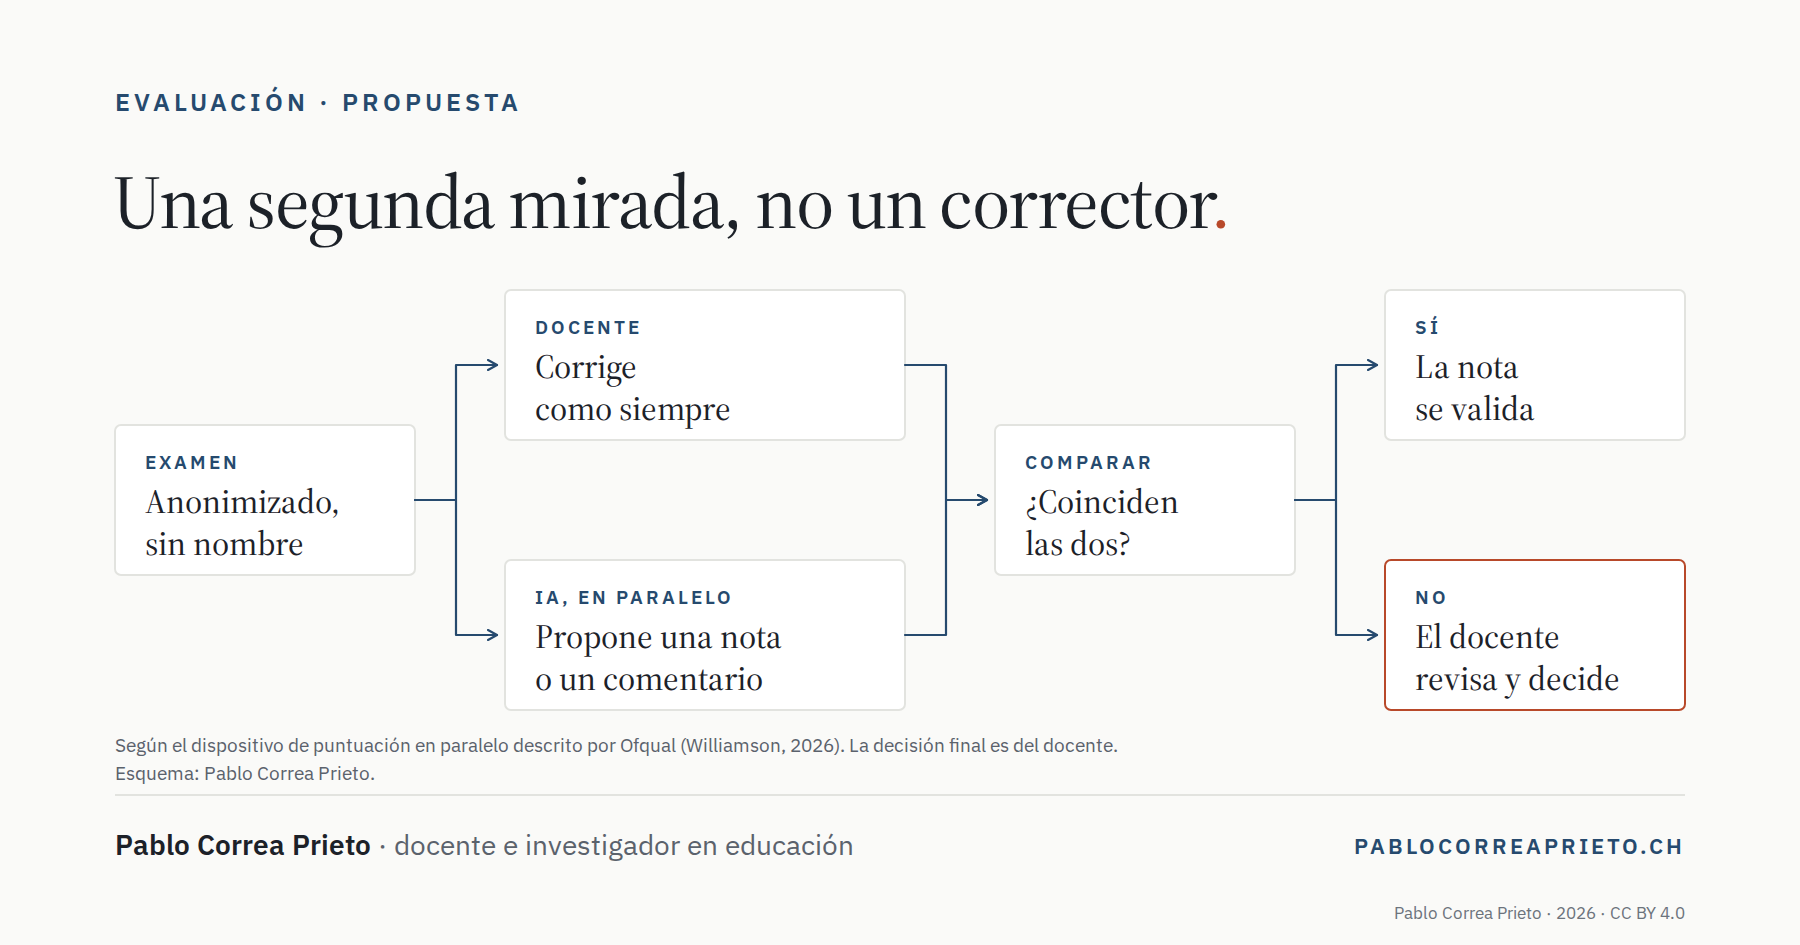
Por eso la veo como una segunda mirada. El docente corrige; la herramienta propone una nota o un comentario en paralelo; solo se revisan los exámenes en los que ambos discrepan. Ofqual, el organismo que regula exámenes y titulaciones en Inglaterra, describe exactamente este dispositivo (la IA puntúa en paralelo al corrector humano y las discrepancias señalan una respuesta que revisar) y señala que evita el efecto de anclaje. Recuerda también que una nota determinada únicamente por la IA no es conforme a su normativa (Williamson, 2026).
© Pablo Correa Prieto, 2026 — CC BY 4.0
Lo que espero de ella es que la herramienta recupere parte de lo que el cansancio o el orden de los exámenes nos hacen pasar por alto. Es una hipótesis: que yo sepa, ningún estudio ha medido todavía, en el aula, cuántos errores de corrección evita una segunda mirada así.
Dos condiciones no se negocian. La primera, la protección de datos. Una ficha de Eduvaud, el portal educativo del cantón de Vaud, dirigida a la secundaria postobligatoria, lo resume en una frase: no transmitir nunca datos personales o sensibles a través de herramientas de IA en línea y, en caso de duda, usar las herramientas que ofrece el cantón (IA et protection des données, 2024). En la práctica: exámenes anonimizados, sin nombre ni dato que permita identificar al alumno. La segunda: la decisión es del docente. La herramienta señala; no decide.
La buena pregunta
La pregunta útil no es, por tanto, «¿corrige la IA sin errores?». Ningún corrector lo consigue. Es más bien: ¿se equivoca menos el docente que corrige con una segunda mirada que el docente que corrige solo? Es una pregunta empírica, y merece ponerse a prueba en nuestras aulas, con nuestros exámenes y nuestros criterios.
Hablemos
¿Ya corrigen con una segunda mirada, humana o no? ¿Han comparado alguna vez sus notas con las de un colega sobre los mismos exámenes? Estaré encantado de conversar. Mis datos de contacto: pablocorreaprieto.ch
Texto redactado con ayuda de una IA, revisado y validado por el autor.
Referencias
- Brimi, H. M. (2011). Reliability of grading high school work in English. Practical Assessment, Research & Evaluation, 16(17). https://eric.ed.gov/?id=EJ954940
- Henkel, O., Hills, L., Boxer, A., Roberts, B. y Levonian, Z. (2024). Can large language models make the grade? An empirical study evaluating LLMs ability to mark short answer questions in K-12 education. En Proceedings of the Eleventh ACM Conference on Learning @ Scale (pp. 300–304). ACM. https://doi.org/10.1145/3657604.3664693
- IA et protection des données [Ficha]. (2024). Portail Eduvaud, Direction générale de l’enseignement postobligatoire. https://www.eduvaud.ch/wp-content/uploads/2025/08/IA_enseignants_exam-vjuillet2025.pdf
- Klein, J. F. y El, L. P. (2003). Impairment of teacher efficiency during extended sessions of test correction. European Journal of Teacher Education, 26(3), 379–392. https://doi.org/10.1080/0261976032000128201
- Meadows, M. y Billington, L. (2005). A review of the literature on marking reliability [Informe para la National Assessment Agency]. https://filestore.aqa.org.uk/content/research/CERP_RP_MM_01052005.pdf
- Seßler, K., Fürstenberg, M., Bühler, B. y Kasneci, E. (2025). Can AI grade your essays? A comparative analysis of large language models and teacher ratings in multidimensional essay scoring. En Proceedings of the 15th International Learning Analytics and Knowledge Conference (LAK ’25) (pp. 462–472). ACM. https://doi.org/10.1145/3706468.3706527
- Starch, D. y Elliott, E. C. (1912). Reliability of the grading of high-school work in English. The School Review, 20(7), 442–457. https://doi.org/10.1086/435971
- Starch, D. y Elliott, E. C. (1913). Reliability of grading work in mathematics. The School Review, 21(4), 254–259. https://doi.org/10.1086/436086
- Steiss, J., Tate, T., Graham, S., Cruz, J., Hebert, M., Wang, J., Moon, Y., Tseng, W., Warschauer, M. y Olson, C. B. (2024). Comparing the quality of human and ChatGPT feedback of students’ writing. Learning and Instruction, 91, Artículo 101894. https://doi.org/10.1016/j.learninstruc.2024.101894
- Williamson, J. (2026). Principles of AI use in marking [Documento de trabajo]. Ofqual. https://www.gov.uk/government/publications/principles-of-ai-use-in-marking