Article · L’IA et l’évaluation
Corriger avec l’IA : se comparer à nos vraies erreurs, pas à la perfection
© Pablo Correa Prieto, 2026 — CC BY 4.0
Dans un premier article, j’écrivais qu’on compare souvent l’IA à un idéal sans erreur, alors que la comparaison honnête se fait avec nos propres pratiques de correction. Cette affirmation mérite des preuves. Pour savoir ce que vaut un outil qui aide à corriger, il faut d’abord savoir ce que vaut la correction humaine. Sur ce point, la recherche est ancienne, abondante et peu flatteuse pour nous.
1.Une même copie, des notes très différentes
En 1912, Daniel Starch et Edward Elliott envoient les deux mêmes copies d’examen d’anglais à deux cents écoles secondaires américaines ; 142 enseignants les notent. Interrogés, les enseignants estimaient d’ordinaire que deux correcteurs ne s’écarteraient pas de plus de 10 points. En réalité, les notes données à une même copie peuvent s’étaler sur 35 à 40 points, et pour l’une des deux copies, 22 enseignants sur 142 n’accordent pas la note de passage (Starch et Elliott, 1912). L’année suivante, les deux chercheurs refont l’expérience en géométrie : les notes y sont encore plus dispersées qu’en anglais. Leur conclusion concerne directement les enseignants de mathématiques : rien ne garantit qu’une copie de mathématiques se note plus précisément qu’une autre (Starch et Elliott, 1913).
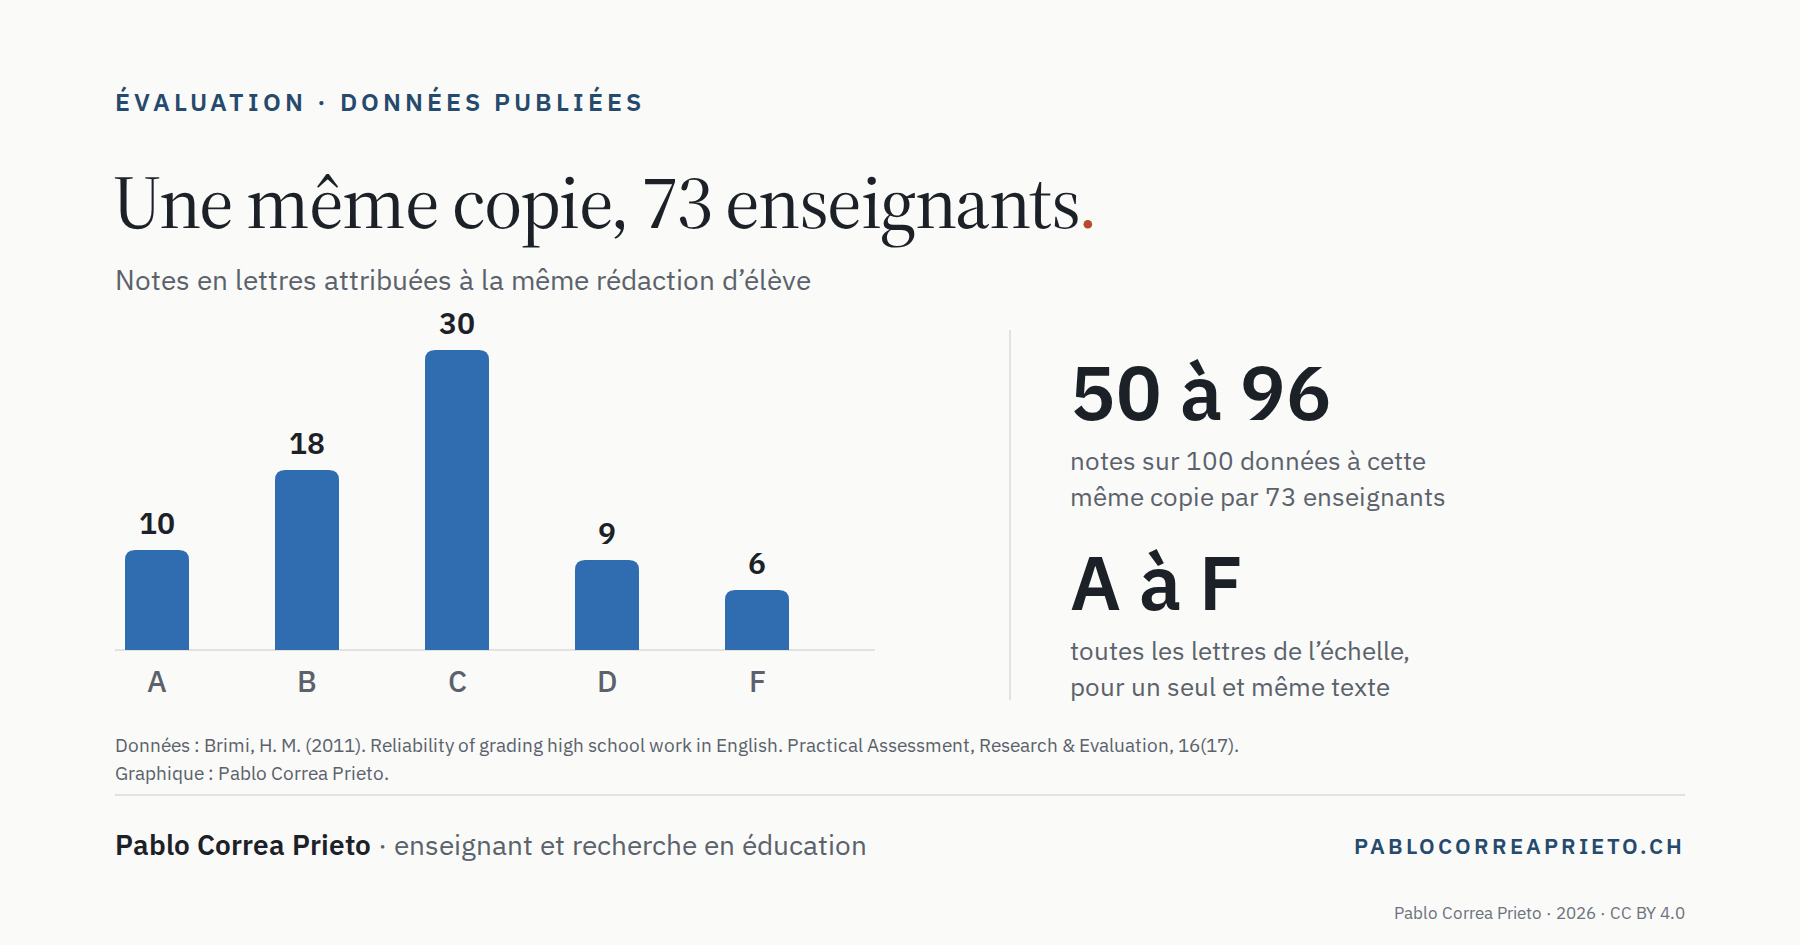
Près d’un siècle plus tard, Hunter Brimi (2011) reprend la question avec 90 enseignants du secondaire qui corrigent la même copie. Parmi les 73 qui notent sur 100, les notes vont de 50 à 96. En lettres, la même copie reçoit 10 A, 18 B, 30 C, 9 D et 6 F.
© Pablo Correa Prieto, 2026 — CC BY 4.0
2.L’ordre des copies et la durée de la séance comptent
Je parlais de la fatigue en fin de pile. Klein et El (2003) ont donné les mêmes 31 rédactions d’élèves de septième année à 60 enseignantes, dans trois ordres différents. Au fil de la pile, les notes montent progressivement, jusqu’à dépasser celles données par des correcteurs spécialisés ; entre les premières et les dernières copies, l’écart moyen atteint environ 10 %. Les auteurs relient ce glissement aux longues séances de correction sans interruption.
L’ordre joue aussi autrement : des enseignants en formation notent plus sévèrement deux copies moyennes quand elles suivent cinq bonnes copies que lorsqu’elles suivent cinq mauvaises (Hales et Tokar, 1975, cités par Meadows et Billington, 2005). La même revue de littérature mentionne toutefois une étude sur la correction d’examens qui ne trouve pas d’effet important du moment où la copie est corrigée. L’effet n’est donc pas toujours le même ; mais notre note dépend en partie de ce que nous venons de lire.
À cela s’ajoute ce que chaque enseignant connaît : un critère appliqué plus largement à la trentième copie qu’à la troisième, une coquille dans un énoncé qu’on ne remarque qu’une fois les copies rendues. Rien de cela n’est une faute professionnelle. C’est le fonctionnement normal d’un correcteur humain.
3.Ce que disent les premières études sur l’IA
Face à cette référence, les grands modèles de langage ne sont ni parfaits ni inutiles. Sur 1 710 réponses courtes d’élèves de 5 à 16 ans en sciences et en histoire, à juger justes ou fausses, GPT-4 atteint un accord de 0,70 (kappa de Cohen) avec les enseignants, contre 0,75 entre enseignants eux-mêmes (Henkel et al., 2024). Sur 20 rédactions d’élèves de 7e et 8e années, notées par 37 enseignants selon dix critères, le meilleur modèle testé obtient une corrélation de 0,74 avec les notes des enseignants ; mais il note plus généreusement et saisit moins bien la qualité du contenu (Seßler et al., 2025). Pour les commentaires rédigés sur des textes d’élèves, des évaluateurs humains formés font mieux que ChatGPT 3.5 dans toutes les catégories sauf une, le respect des critères (Steiss et al., 2024).
Ma lecture de ces résultats : l’IA n’est pas encore un correcteur fiable à elle seule, surtout quand il faut juger le fond d’un texte. Mais l’écart avec un correcteur humain est bien plus faible qu’on ne l’imagine quand on la compare à la perfection.
4.Un second regard, pas un correcteur automatique
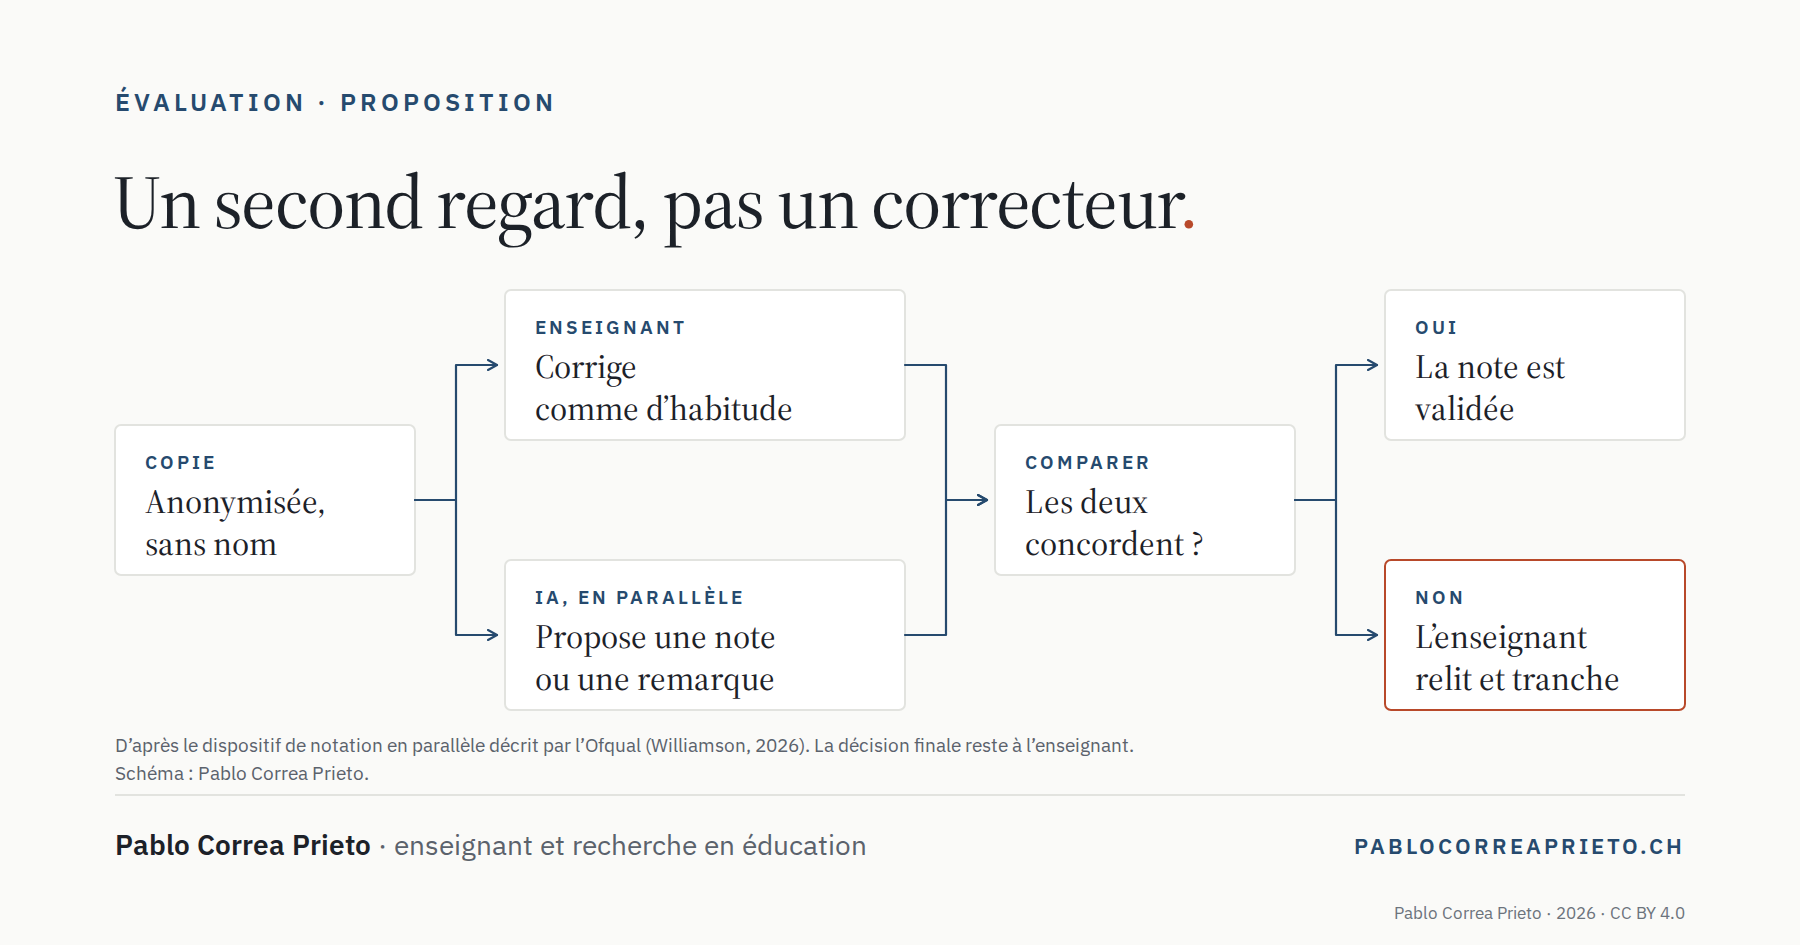
C’est pourquoi je la vois comme un second regard. L’enseignant corrige ; l’outil propose une note ou une remarque en parallèle ; seules les copies où les deux divergent sont relues. L’Ofqual, l’autorité qui régule les examens et les certifications en Angleterre, décrit précisément ce dispositif (l’IA note en parallèle du correcteur humain et les écarts signalent une copie à revoir) et relève qu’il évite l’effet d’ancrage. Elle rappelle aussi qu’une note déterminée par la seule IA n’est pas conforme à ses règles (Williamson, 2026).
© Pablo Correa Prieto, 2026 — CC BY 4.0
Ce que j’en attends, c’est que l’outil rattrape une partie de ce que la fatigue ou l’ordre des copies nous font manquer. C’est une hypothèse : à ma connaissance, aucune étude n’a encore mesuré, en classe, combien d’erreurs de correction un tel second regard permet d’éviter.
Deux conditions ne se négocient pas. D’abord, la protection des données. Une fiche d’Eduvaud destinée au secondaire II le dit en une phrase : « ne jamais transmettre de données personnelles ou sensibles via les outils IA en ligne », et recommande, en cas de doute, les outils proposés par le canton (IA et protection des données, 2024). Concrètement : des copies anonymisées, sans nom ni information permettant d’identifier l’élève. Ensuite, la décision reste à l’enseignant. L’outil signale ; il ne tranche pas.
La bonne question
La question utile n’est donc pas « l’IA corrige-t-elle sans erreur ? ». Aucun correcteur n’y parvient. C’est plutôt : l’enseignant qui corrige avec un second regard se trompe-t-il moins que l’enseignant seul ? C’est une question empirique, et elle mérite d’être testée dans nos classes, avec nos copies et nos critères.
Échangeons
Vous corrigez déjà avec un second regard, humain ou non ? Vous avez déjà comparé vos notes à celles d’un collègue sur les mêmes copies ? Je serai heureux d’en discuter. Mes coordonnées : pablocorreaprieto.ch
Texte rédigé avec l’aide d’une IA, relu et validé par l’auteur.
Références
- Brimi, H. M. (2011). Reliability of grading high school work in English. Practical Assessment, Research & Evaluation, 16(17). https://eric.ed.gov/?id=EJ954940
- Henkel, O., Hills, L., Boxer, A., Roberts, B. et Levonian, Z. (2024). Can large language models make the grade? An empirical study evaluating LLMs ability to mark short answer questions in K-12 education. Dans Proceedings of the Eleventh ACM Conference on Learning @ Scale (p. 300–304). ACM. https://doi.org/10.1145/3657604.3664693
- IA et protection des données [Fiche]. (2024). Portail Eduvaud, Direction générale de l’enseignement postobligatoire. https://www.eduvaud.ch/wp-content/uploads/2025/08/IA_enseignants_exam-vjuillet2025.pdf
- Klein, J. F. et El, L. P. (2003). Impairment of teacher efficiency during extended sessions of test correction. European Journal of Teacher Education, 26(3), 379–392. https://doi.org/10.1080/0261976032000128201
- Meadows, M. et Billington, L. (2005). A review of the literature on marking reliability [Rapport pour la National Assessment Agency]. https://filestore.aqa.org.uk/content/research/CERP_RP_MM_01052005.pdf
- Seßler, K., Fürstenberg, M., Bühler, B. et Kasneci, E. (2025). Can AI grade your essays? A comparative analysis of large language models and teacher ratings in multidimensional essay scoring. Dans Proceedings of the 15th International Learning Analytics and Knowledge Conference (LAK ’25) (p. 462–472). ACM. https://doi.org/10.1145/3706468.3706527
- Starch, D. et Elliott, E. C. (1912). Reliability of the grading of high-school work in English. The School Review, 20(7), 442–457. https://doi.org/10.1086/435971
- Starch, D. et Elliott, E. C. (1913). Reliability of grading work in mathematics. The School Review, 21(4), 254–259. https://doi.org/10.1086/436086
- Steiss, J., Tate, T., Graham, S., Cruz, J., Hebert, M., Wang, J., Moon, Y., Tseng, W., Warschauer, M. et Olson, C. B. (2024). Comparing the quality of human and ChatGPT feedback of students’ writing. Learning and Instruction, 91, Article 101894. https://doi.org/10.1016/j.learninstruc.2024.101894
- Williamson, J. (2026). Principles of AI use in marking [Document de travail]. Ofqual. https://www.gov.uk/government/publications/principles-of-ai-use-in-marking