Artículo · Evaluación y plan de estudios
Un ítem correcto no siempre está alineado: tres preguntas para juzgar un ítem de evaluación
© Pablo Correa Prieto, 2026 — CC BY 4.0
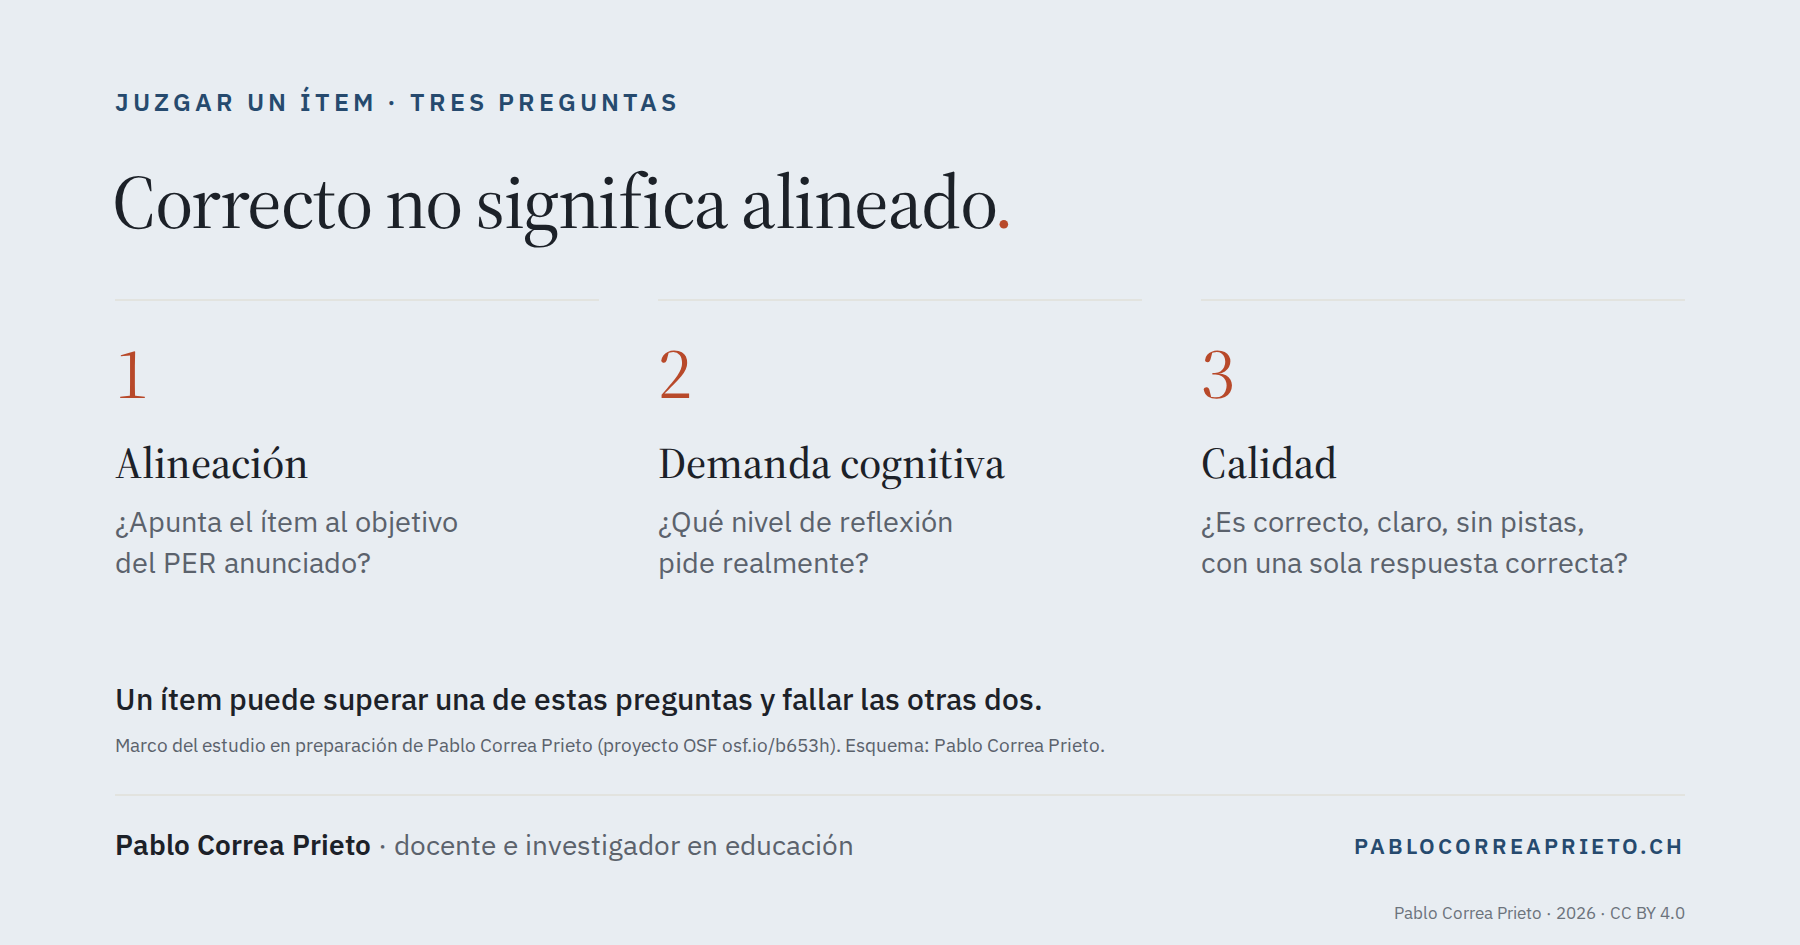
En mi investigación en curso me pregunto si los grandes modelos de lenguaje pueden producir ítems de evaluación de matemáticas para el ciclo 3 conformes al Plan d’études romand (PER), el plan de estudios de la Suiza francófona. Antes incluso de mirar lo que producen estas herramientas, hay que ponerse de acuerdo sobre qué significa «conforme». Lo descompongo en tres preguntas, porque un ítem puede superar una y fallar las otras dos.
© Pablo Correa Prieto, 2026 — CC BY 4.0
1.Alineación: ¿apunta el ítem al objetivo anunciado?
El PER organiza cada disciplina en objetivos de aprendizaje, que traducen sus metas prioritarias (visées prioritaires) para el ciclo correspondiente, acompañados de una progresión de los aprendizajes y de unas expectativas fundamentales (attentes fondamentales) (CIIP, s. f.). En el ciclo 3, la progresión se define por curso escolar. Un ítem está alineado si evalúa lo que pide el objetivo previsto, y no un contenido vecino.
El término viene de la investigación en evaluación. Norman Webb (1997) define la alineación como el grado de acuerdo entre las expectativas y las evaluaciones, y la descompone en varios criterios. El primero, la concordancia de categorías, exige que las mismas categorías de contenido aparezcan en las expectativas y en la evaluación. Ese es el sentido que doy aquí a la palabra: una correspondencia de contenido con un objetivo concreto del PER.
¿Por qué insistir? Porque un ítem puede ser matemáticamente correcto y, aun así, estar fuera de objetivo. En un estudio reciente sobre problemas de matemáticas generados por modelos de lenguaje y evaluados, entre otros, por docentes frente a estándares estadounidenses (grados 3 a 5), la mayoría de los errores de alineación venían de problemas que dejaban fuera elementos importantes del estándar previsto (Christ et al., 2026). El problema no es entonces falso; está incompleto respecto a lo que se quería evaluar.
2.Demanda cognitiva: ¿qué nivel de reflexión pide realmente el ítem?
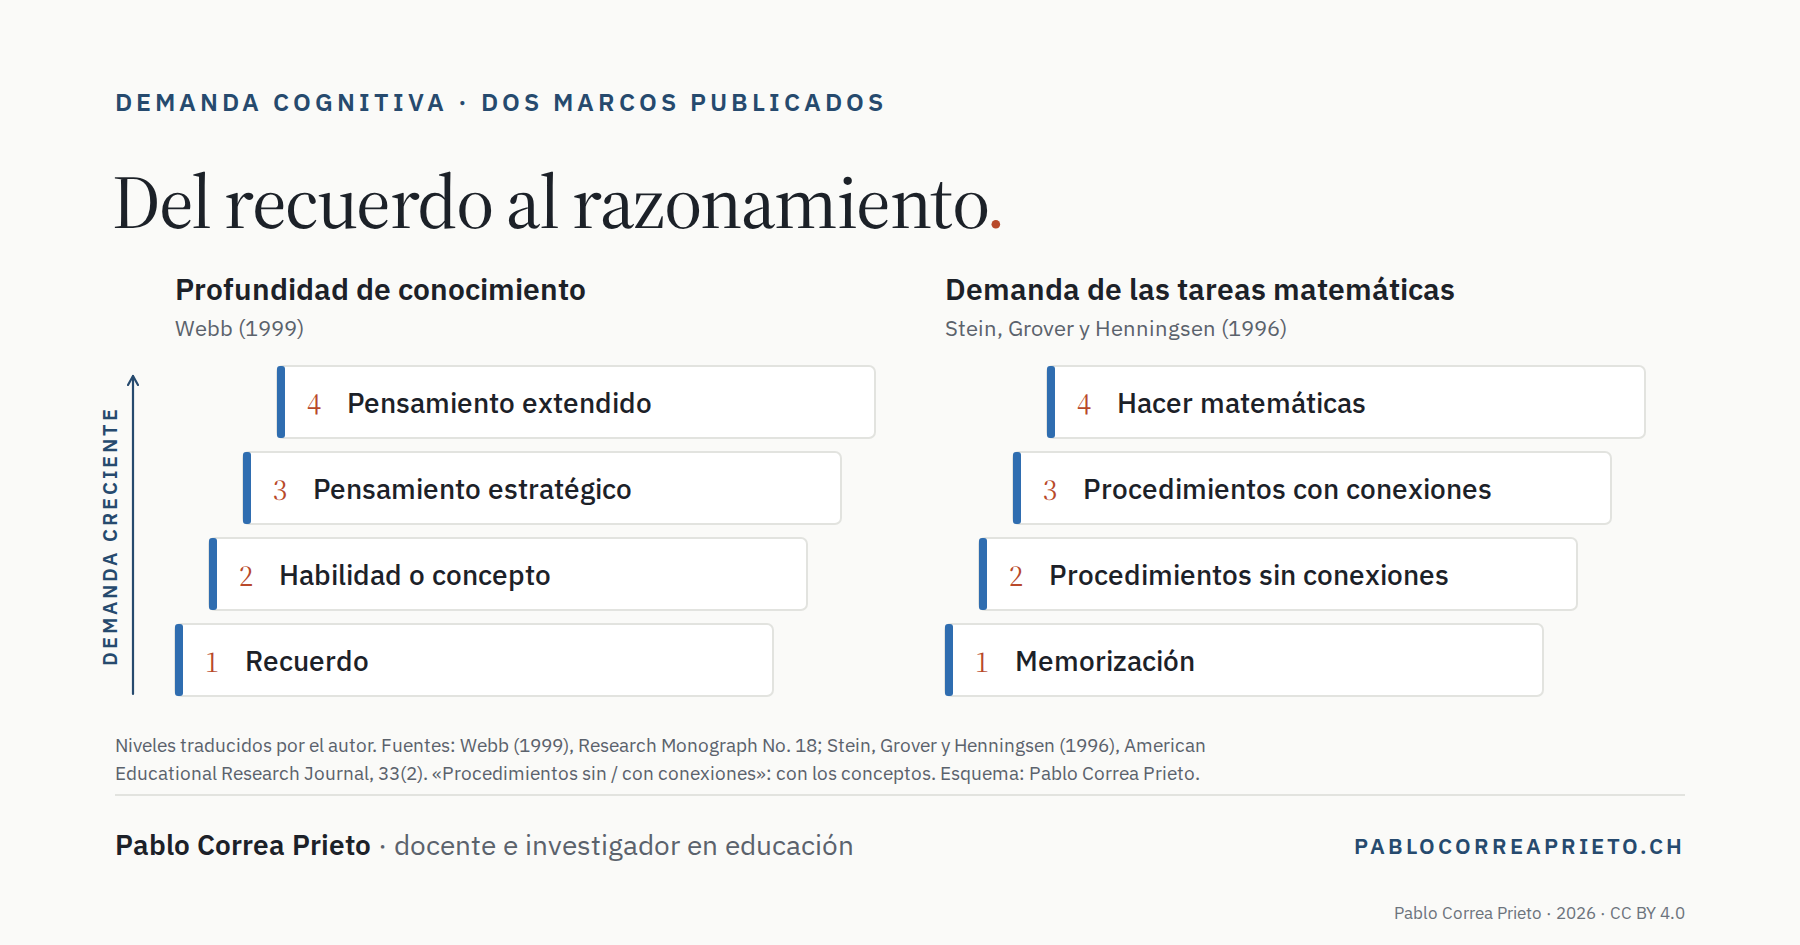
Dos ítems alineados con el mismo objetivo pueden pedir cosas muy distintas al alumno: recordar un dato, aplicar un procedimiento o razonar y justificar. Webb (1999) distingue cuatro niveles de profundidad de conocimiento: el recuerdo, la habilidad o el concepto, el pensamiento estratégico y el pensamiento extendido. En didáctica de las matemáticas, Stein, Grover y Henningsen (1996) describen demandas que van de la memorización al uso de procedimientos sin o con conexiones con los conceptos, hasta «hacer matemáticas». Su marco se diseñó para tareas de aula; aplicarlo a ítems de evaluación exige una adaptación, y es un punto de método que hay que explicitar.
© Pablo Correa Prieto, 2026 — CC BY 4.0
De hecho, Webb trata esta cuestión dentro de la alineación: una evaluación está alineada si lo que pide a los alumnos es tan exigente cognitivamente como lo que se espera que sepan hacer (Webb, 1997). Yo la separo a propósito, porque ambas pueden divergir: un ítem puede apuntar al objetivo correcto pidiendo solo un recuerdo. Es un riesgo que señalan McGalliard y Otten (2025): según ellos, la IA generativa tiende por ahora a producir tareas de baja demanda cognitiva.
3.Calidad: ¿es el ítem correcto, claro y utilizable?
Un ítem alineado y exigente puede estar aún mal construido. Haladyna, Downing y Rodriguez (2002) reunieron 31 recomendaciones para redactar ítems de opción múltiple. Varias valen para cualquier ítem: una consigna muy clara, una sola respuesta correcta y ninguna pista que delate la respuesta (una palabra como «siempre» o «nunca», una incoherencia gramatical, una opción que salta a la vista). Para un ítem de matemáticas, añado la exactitud misma: datos coherentes y una solución comprobada.
En este punto, los modelos recientes a veces lo hacen mejor de lo que se piensa. En un estudio en la enseñanza superior, en programación, GPT-4 producía preguntas de opción múltiple con un lenguaje claro, una sola respuesta correcta y distractores de buena calidad, que parecían bien alineadas con los objetivos de los cursos (Doughty et al., 2024). Ese resultado vale para ese contexto; no dice nada del PER ni del ciclo 3. Razón de más para plantear las tres preguntas por separado, sobre nuestros propios objetivos.
Por qué tres preguntas y no una
Preguntar «¿es bueno este ítem?» mezcla tres juicios. Un ítem puede ser correcto pero estar fuera de objetivo, estar alineado pero ser demasiado fácil, ser exigente pero ambiguo. Al separarlos, sabemos qué corregir: cambiar el objetivo previsto, subir la exigencia o reescribir el enunciado. Es también lo que hace posible un estudio serio: no se puede decir si una herramienta produce «buenos» ítems sin decir buenos según qué.
El protocolo y el material de mi estudio se depositarán en el proyecto OSF. Este artículo solo presenta el marco, sin resultados.
Hablemos
¿Diseñan evaluaciones para el ciclo 3 o trabajan sobre la alineación con el PER? Estaré encantado de conversar. Mis datos de contacto: pablocorreaprieto.ch
Texto redactado con ayuda de una IA, revisado y validado por el autor.
Referencias
- Christ, B. R., Molitz, P., LeBlond, B., Gottesman, Z., Kropko, J. y Hartvigsen, T. (2026). EDUMATH: Generating standards-aligned educational math word problems. En Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (pp. 42611–42643). Association for Computational Linguistics. https://doi.org/10.18653/v1/2026.acl-long.1973
- Conférence intercantonale de l’instruction publique et de la culture de la Suisse romande et du Tessin [CIIP]. (s. f.). Les domaines disciplinaires. Plan d’études romand. Recuperado el 28 de septiembre de 2026, de https://portail.ciip.ch/per/pages/245
- Doughty, J., Wan, Z., Bompelli, A., Qayum, J., Wang, T., Zhang, J., Zheng, Y., Doyle, A., Sridhar, P., Agarwal, A., Bogart, C., Keylor, E., Kultur, C., Savelka, J. y Sakr, M. (2024). A comparative study of AI-generated (GPT-4) and human-crafted MCQs in programming education. En Proceedings of the 26th Australasian Computing Education Conference (pp. 114–123). ACM. https://doi.org/10.1145/3636243.3636256
- Haladyna, T. M., Downing, S. M. y Rodriguez, M. C. (2002). A review of multiple-choice item-writing guidelines for classroom assessment. Applied Measurement in Education, 15(3), 309–333. https://doi.org/10.1207/S15324818AME1503_5
- McGalliard, W. y Otten, S. (2025). AI responses to challenging problems and educator responses to AI availability. Digital Experiences in Mathematics Education, 11, 319–332. https://doi.org/10.1007/s40751-024-00167-4
- Stein, M. K., Grover, B. W. y Henningsen, M. (1996). Building student capacity for mathematical thinking and reasoning: An analysis of mathematical tasks used in reform classrooms. American Educational Research Journal, 33(2), 455–488. https://doi.org/10.3102/00028312033002455
- Webb, N. L. (1997). Criteria for alignment of expectations and assessments in mathematics and science education (Research Monograph No. 6). National Institute for Science Education; Council of Chief State School Officers. https://eric.ed.gov/?id=ED414305
- Webb, N. L. (1999). Alignment of science and mathematics standards and assessments in four states (Research Monograph No. 18). National Institute for Science Education; Council of Chief State School Officers. https://eric.ed.gov/?id=ED440852