Article · Évaluation et plan d’études
Un item juste n’est pas forcément aligné : trois questions pour juger un item d’évaluation
© Pablo Correa Prieto, 2026 — CC BY 4.0
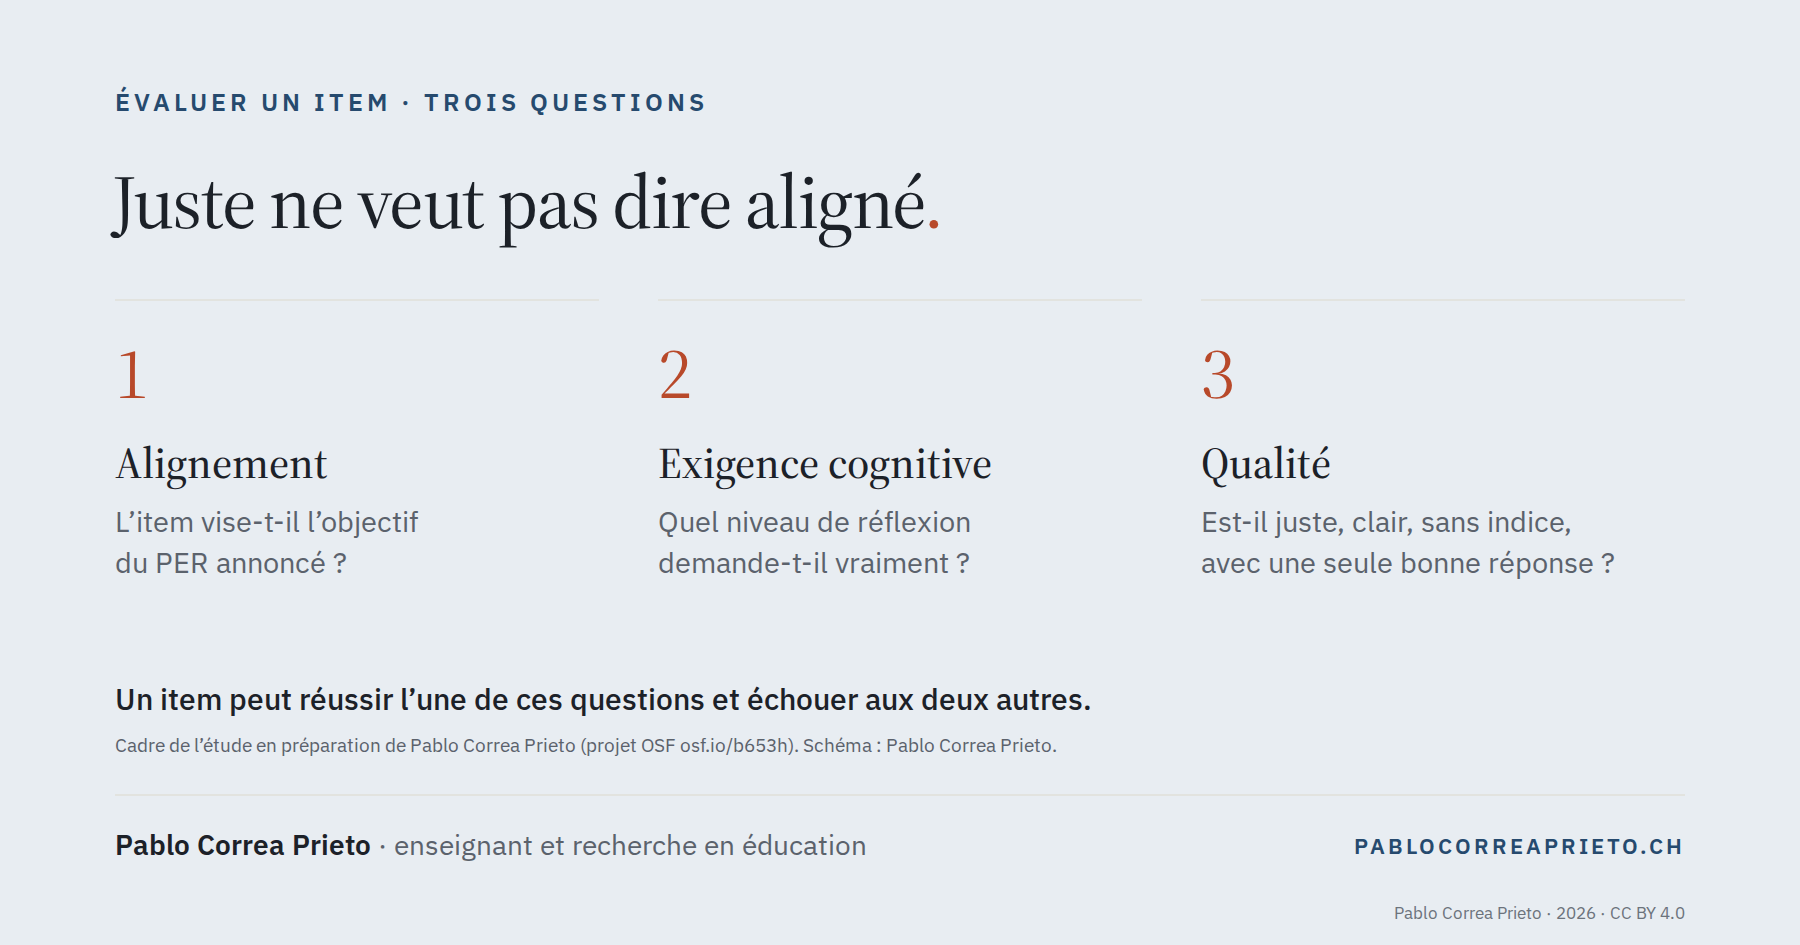
Dans ma recherche en cours, je me demande si les grands modèles de langage peuvent produire des items d’évaluation en mathématiques pour le cycle 3 conformes au Plan d’études romand (PER). Avant même de regarder ce que produisent ces outils, il faut s’entendre sur ce que « conforme » veut dire. Je le décompose en trois questions, parce qu’un item peut réussir l’une et échouer aux deux autres.
© Pablo Correa Prieto, 2026 — CC BY 4.0
1.Alignement : l’item vise-t-il l’objectif annoncé ?
Le PER organise chaque discipline en objectifs d’apprentissage, « à mettre en relation avec les Visées prioritaires dont ils sont la traduction pour le cycle considéré », accompagnés d’une progression des apprentissages et d’attentes fondamentales (CIIP, s.d.). Au cycle 3, la progression est définie par année scolaire. Un item est aligné s’il évalue bien ce que l’objectif visé demande, et non un contenu voisin.
Le terme vient de la recherche en évaluation. Norman Webb (1997) définit l’alignement comme le degré d’accord entre les attentes et les évaluations, et le décompose en plusieurs critères. Le premier, la concordance des catégories, demande que les mêmes catégories de contenu apparaissent dans les attentes et dans l’évaluation. C’est le sens que je donne ici au mot : une correspondance de contenu avec un objectif précis du PER.
Pourquoi insister ? Parce qu’un item peut être mathématiquement juste et pourtant hors cible. Dans une étude récente sur des problèmes de mathématiques générés par des modèles de langage, évalués notamment par des enseignants au regard de standards américains (degrés 3 à 5), la plupart des erreurs d’alignement viennent de problèmes qui laissent de côté des éléments importants du standard visé (Christ et al., 2026). Le problème n’est alors pas faux ; il est incomplet par rapport à ce qu’on voulait évaluer.
2.Exigence cognitive : quel niveau de réflexion l’item demande-t-il vraiment ?
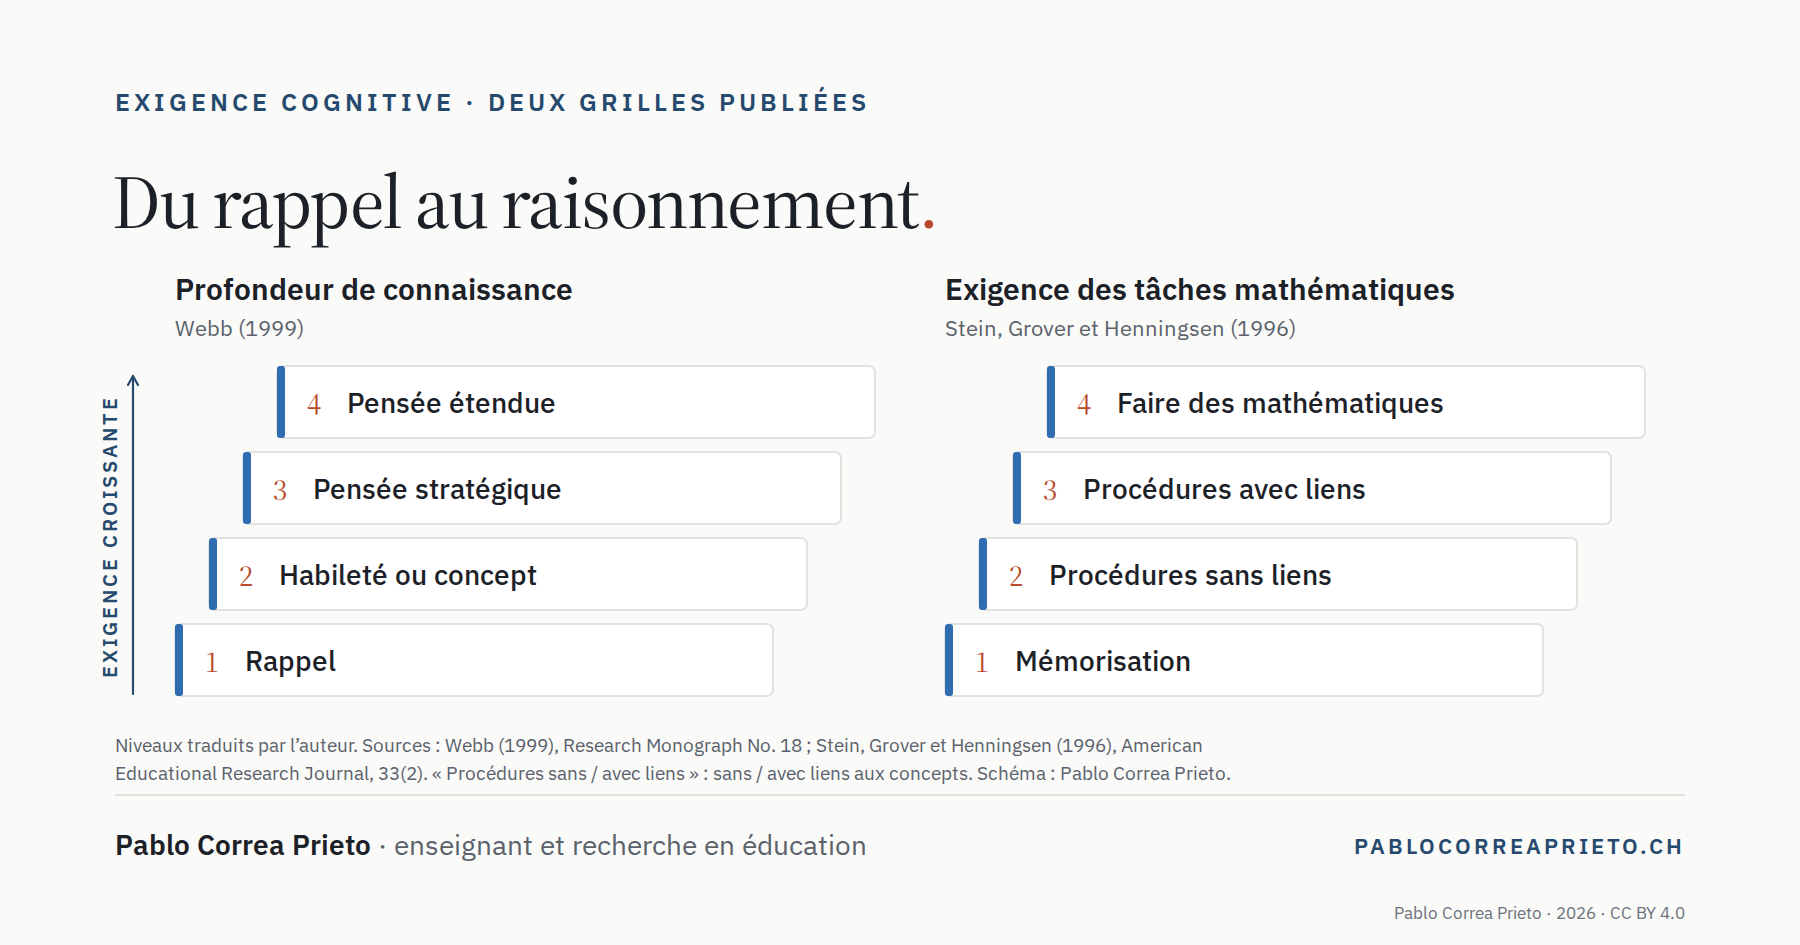
Deux items alignés sur le même objectif peuvent demander des choses très différentes à l’élève : retrouver un fait, appliquer une procédure, ou raisonner et justifier. Webb (1999) distingue quatre niveaux de profondeur de connaissance : le rappel, l’habileté ou le concept, la pensée stratégique et la pensée étendue. En didactique des mathématiques, Stein, Grover et Henningsen (1996) décrivent des exigences qui vont de la mémorisation à l’usage de procédures sans ou avec liens aux concepts, jusqu’au fait de « faire des mathématiques ». Leur grille a été conçue pour des tâches de classe ; l’appliquer à des items d’évaluation demande une adaptation, et c’est un point de méthode à expliciter.
© Pablo Correa Prieto, 2026 — CC BY 4.0
Webb traite d’ailleurs cette question à l’intérieur de l’alignement : une évaluation est alignée si ce qu’elle demande aux élèves est aussi exigeant, sur le plan cognitif, que ce qu’ils sont censés savoir faire (Webb, 1997). Je la sépare volontairement, parce que les deux peuvent diverger : un item peut viser le bon objectif en ne demandant qu’un rappel. C’est un risque que signalent McGalliard et Otten (2025) : selon eux, l’IA générative tend pour l’instant à produire des tâches de faible exigence cognitive.
3.Qualité : l’item est-il juste, clair et utilisable ?
Un item aligné et exigeant peut encore être mal construit. Haladyna, Downing et Rodriguez (2002) ont réuni 31 recommandations pour la rédaction d’items à choix multiples. Plusieurs valent pour tout item : une consigne très claire, une seule bonne réponse, et aucun indice qui trahisse la réponse (un mot comme « toujours » ou « jamais », une incohérence grammaticale, une option qui saute aux yeux). Pour un item de mathématiques, j’ajoute l’exactitude elle-même : des données cohérentes et une solution vérifiée.
Sur ce point, les modèles récents font parfois mieux qu’on ne le pense. Dans une étude menée dans l’enseignement supérieur, en programmation, GPT-4 produisait des questions à choix multiples à la langue claire, avec une seule bonne réponse et des distracteurs de bonne qualité, qui semblaient bien alignées sur les objectifs des cours (Doughty et al., 2024). Ce résultat vaut pour ce contexte ; il ne dit rien du PER ni du cycle 3. C’est une raison de plus pour poser les trois questions séparément, sur nos propres objectifs.
Pourquoi trois questions plutôt qu’une
Demander « cet item est-il bon ? » mélange trois jugements. Un item peut être juste mais hors cible, aligné mais trop facile, exigeant mais ambigu. En les séparant, on sait ce qu’il faut corriger : changer l’objectif visé, relever l’exigence ou réécrire l’énoncé. C’est aussi ce qui rend possible une étude sérieuse : on ne peut pas dire si un outil produit de « bons » items sans dire bons selon quoi.
Le protocole et le matériel de mon étude seront déposés sur le projet OSF. Cet article n’en présente que le cadre, sans résultat.
Échangeons
Vous concevez des évaluations au cycle 3, ou vous travaillez sur l’alignement au PER ? Je serai heureux d’en discuter. Mes coordonnées : pablocorreaprieto.ch
Texte rédigé avec l’aide d’une IA, relu et validé par l’auteur.
Références
- Christ, B. R., Molitz, P., LeBlond, B., Gottesman, Z., Kropko, J. et Hartvigsen, T. (2026). EDUMATH: Generating standards-aligned educational math word problems. Dans Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers) (p. 42611–42643). Association for Computational Linguistics. https://doi.org/10.18653/v1/2026.acl-long.1973
- Conférence intercantonale de l’instruction publique et de la culture de la Suisse romande et du Tessin [CIIP]. (s.d.). Les domaines disciplinaires. Plan d’études romand. Consulté le 28 septembre 2026, à l’adresse https://portail.ciip.ch/per/pages/245
- Doughty, J., Wan, Z., Bompelli, A., Qayum, J., Wang, T., Zhang, J., Zheng, Y., Doyle, A., Sridhar, P., Agarwal, A., Bogart, C., Keylor, E., Kultur, C., Savelka, J. et Sakr, M. (2024). A comparative study of AI-generated (GPT-4) and human-crafted MCQs in programming education. Dans Proceedings of the 26th Australasian Computing Education Conference (p. 114–123). ACM. https://doi.org/10.1145/3636243.3636256
- Haladyna, T. M., Downing, S. M. et Rodriguez, M. C. (2002). A review of multiple-choice item-writing guidelines for classroom assessment. Applied Measurement in Education, 15(3), 309–333. https://doi.org/10.1207/S15324818AME1503_5
- McGalliard, W. et Otten, S. (2025). AI responses to challenging problems and educator responses to AI availability. Digital Experiences in Mathematics Education, 11, 319–332. https://doi.org/10.1007/s40751-024-00167-4
- Stein, M. K., Grover, B. W. et Henningsen, M. (1996). Building student capacity for mathematical thinking and reasoning: An analysis of mathematical tasks used in reform classrooms. American Educational Research Journal, 33(2), 455–488. https://doi.org/10.3102/00028312033002455
- Webb, N. L. (1997). Criteria for alignment of expectations and assessments in mathematics and science education (Research Monograph No. 6). National Institute for Science Education; Council of Chief State School Officers. https://eric.ed.gov/?id=ED414305
- Webb, N. L. (1999). Alignment of science and mathematics standards and assessments in four states (Research Monograph No. 18). National Institute for Science Education; Council of Chief State School Officers. https://eric.ed.gov/?id=ED440852